Spring MyBatis Plus
概述
MyBatis-Plus(简称MP)是一个基于MyBatis框架的增强工具,它在MyBatis的基础上只做增强而不做改变,旨在简化开发、提高效率。MP提供了一系列的功能和特性,使得开发人员能够更加高效地使用MyBatis进行数据库操作
官网:MyBatis-Plus
快速入门
环境搭建:先利用Tlias系统进行测试,可以从中州养老项目中给出的资料获取项目代码
导入依赖
导入MyBatis-Plus的起步依赖,替换掉MyBatis的起步依赖
<dependency>
    <groupId>com.baomidou</groupId>
    <artifactId>mybatis-plus-spring-boot3-starter</artifactId>
    <version>3.5.11</version>
</dependency>
接着,在引导类上添加注解,配置自动扫描Mapper
@MapperScan("com.itheima.mapper")   // 添加这段注解
@ServletComponentScan
@SpringBootApplication
public class TliasWebManagementApplication {
    public static void main(String[] args) {
        SpringApplication.run(TliasWebManagementApplication.class, args);
    }
}
定义Mapper
为了简化单表CRUD,Mybatis-Plus提供了一个基础的BaseMapper接口,其中已经实现了单表的CRUD:
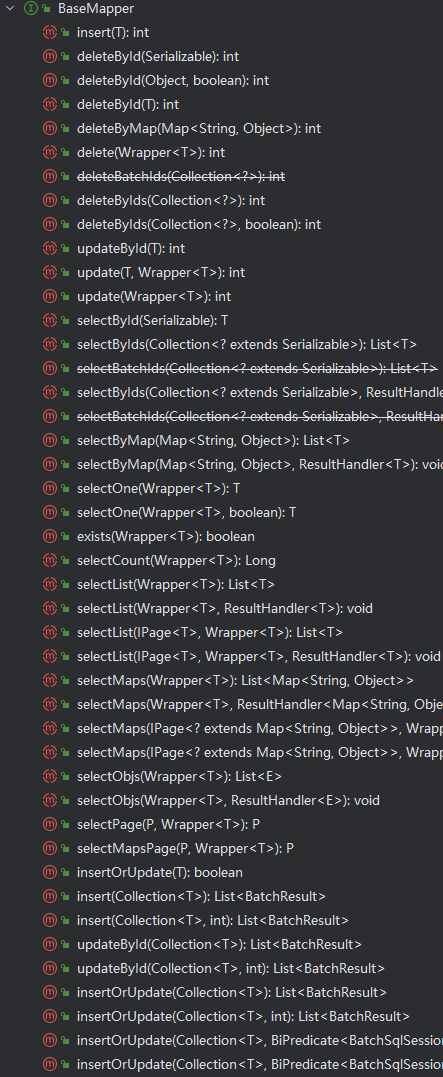
因此咱们自定义的Mapper只要实现了这个BaseMapper,就无需自己实现单表CRUD了。
修改DeptProjectMapper接口,让其继承BaseMapper,接口中的代码可以全部注释掉或者删除:
@Mapper
public interface DeptMapper extends BaseMapper<Dept> {

    /*
    @Select("select id, name, create_time, update_time from dept order by update_time desc ")
    List<Dept> findAll();

    @Delete("delete from dept where id = #{id}")
    void deleteById(Integer id);

    @Insert("insert into dept(name, create_time, update_time) values (#{name}, #{createTime}, #{updateTime})")
    void save(Dept dept);

    Dept getById(Integer id);

    @Update("update dept set name = #{name}, update_time = #{updateTime} where id = #{id}")
    void update(Dept dept);
    */
}
同时可以把对应的xml映射文件改个名字或删除(彻底失效)
由于DeptMapper中进行了修改,所以还需要将对应Service层的代码进行修改:
@Service
public class DeptServiceImpl implements DeptService {
    @Autowired
    private DeptMapper deptMapper;

    @Override
    public List<Dept> findAll() {
        return deptMapper.selectList(null);
    }

    @Override
    public void deleteById(Integer id) {
        deptMapper.deleteById(id);
    }

    @Override
    public void save(Dept dept) {
        // 补全基础属性
        dept.setCreateTime(LocalDateTime.now());
        dept.setUpdateTime(LocalDateTime.now());

        // 调用Mapper层方法保存数据
        deptMapper.insert(dept);
    }

    @Override
    public Dept getById(Integer id) {
        Dept dept = deptMapper.selectById(id);
        return dept;
    }

    @Override
    public void update(Dept dept) {
        // 补全基础属性
        dept.setUpdateTime(LocalDateTime.now());
        deptMapper.updateById(dept);
    }
}
最后,修改Dept.java这个实体类,设置主键增长策略为自增:
@Data
@NoArgsConstructor
@AllArgsConstructor
public class Dept {
    @TableId(value = "id",type = IdType.AUTO)
    private Integer id;
    private String name;
    private LocalDateTime createTime;
    private LocalDateTime updateTime;
}
常见注解(实体类映射数据表)
在上面的案例中,对于Mapper层来说,虽然没有编写任何SQL代码,但是MP依旧可以知道是对哪张表进行操作,主要的原因如下:
DeptMapper在继承BaseMapper时,指定了一个泛型
@Mapper
public interface DeptMapper extends BaseMapper<Dept> {

}
泛型中的Dept就是与数据库表对应的POJO
MP就是根据实体类的信息,通过反射来推断出表的信息,从而生成SQL的。规则如下:
- MP会把实体类的类名(驼峰转下划线)作为表名
- MP会把名为id的字段作为主键
- MP会把实体类的所有变量名(驼峰转下划线)作为表的字段名,并根据变量类型推断字段类型
但有些情况下,实体类的类名与表名不完全一致,又或者实体类中的属性名和数据表中的字段名无法完全对应,因此MP提供了一些注解便于声明表信息,常用的有下面几个注解:
- @TableName:用来指定表名
- @TableField:用来指定表中的普通字段信息
- @TableId:用来指定表中的主键字段信息
@TableName
- 描述:表名注解,标识实体类对应的表
- 使用位置:实体类
- 示例:
@Data
@AllArgsConstructor
@NoArgsConstructor
@TableName("tb_user")
public class User {
    private Long id;
    private String name;
    private Boolean isMarried;
    private Integer order;
    private String address;
}
@TableField
- 普通字段注解
- 示例:
@Data
@AllArgsConstructor
@NoArgsConstructor
@TableName("tb_user")
public class User {
    private Long id;
    @TableField("username")
    private String name;
    private Boolean isMarried;
    @TableField("`order`")
    private Integer order;
    @TableField(exist=false)
    private String address;
}
一般情况下是不需要为成员变量添加@TableField注解,一些特殊情况除外:
- 成员变量名与数据库字段名不一致
- 成员变量与数据库一致,但是与数据库的关键字冲突。使用@TableField注解结合
``指定字段名称 - 成员变量不是数据库中的字段,则需要将
exist属性设置为false,明确告知MP该字段在数据表中不存在
@TableId
- 描述:主键注解,标识实体类中的主键字段和主键生成类型
- 使用位置:实体类的主键字段
- 示例:
@Data
@NoArgsConstructor
@AllArgsConstructor
@TableName("tb_user")
public class User {
    @TableId(value = "id", type = IdType.AUTO)
    private Long id;

    private String name;

    private Boolean isMarried;

    private Integer order;

    private String address;
}
- @TableId注解支持两个属性:
value:指定数据库表中的主键字段名称
IdType:指定主键生成类型,支持的类型有:
- **
IdType.AUTO**:使用数据库自增 ID 作为主键。 IdType.NONE:无特定生成策略,如果全局配置中有 IdType 相关的配置,则会跟随全局配置。IdType.INPUT:在插入数据前,由用户自行设置主键值。- **
IdType.ASSIGN_ID**:自动分配ID,适用于Long、Integer、String类型的主键。
默认使用雪花算法通过 IdentifierGenerator 的 nextId 实现,这是默认的ID策略。
IdType.ASSIGN_UUID:自动分配UUID,适用于String类型的主键。默认实现为IdentifierGenerator的nextUUID方法。
常见配置
Mybatis-Plus也支持基于yml文件的自定义配置,详见官方文档:使用配置 | MyBatis-Plus
常见的配置:
- 全局id类型
mybatis-plus:
  global-config:
    db-config:
      id-type: auto             # 全局id类型为自增长
      update-strategy: not_null # 更新策略:只更新非空字段
Mybatis-Plus也支持手写SQL的,而mapper层的xml映射文件的读取位置可以自己配置:
type-aliases-package:指定 MyBatis 别名包扫描路径,用于给包中的类注册别名。注册后,在 Mapper 对应的 XML 文件中可以直接使用类名,无需使用全限定类名mapper-locations:指定 MyBatis 的 Mapper 层 XML 映射文件的位置,默认值:["classpath*:/mapper/**/*.xml"]
mybatis-plus:
  type-aliases-package: com.itheima.pojo
  mapper-locations: classpath:mapper/**/*Mapper.xml
  configuration:
    map-underscore-to-camel-case: true
    log-impl: org.apache.ibatis.logging.stdout.StdOutImpl

  global-config:
    db-config:
      id-type: auto             # 全局id类型为自增长
      update-strategy: not_null # 更新策略:只更新非空字段
mapper-locations也可以配置成classpath*:mapper/**.xml,也就是说只要把mapper.xml文件放置在mapper目录下就一定会被加载。
通过以上的配置信息,可以将DeptMapper.xml中的实体类resultType属性的包名省略:
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE mapper
        PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
        "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.itheima.mapper.DeptMapper">
    <select id="getById" resultType="Dept"><!-- 原本resultType="com.itheima.pojo.Dept" -->
        select id, name, create_time, update_time from dept where id = #{id}
    </select>
</mapper>
核心功能
刚才的案例中都是以id为条件的简单CRUD,一些复杂条件的SQL语句就要用到一些更高级的功能了,Mybatis-Plus中的核心功能,包括两部分内容:
- 条件构建器
- IService接口
条件构建器
除了查询以外,修改、删除的SQL语句都需要指定where条件。因此BaseMapper中不仅仅提供了接收id作为where条件的方法,还提供了一组可以接收更加复杂的where条件的方法
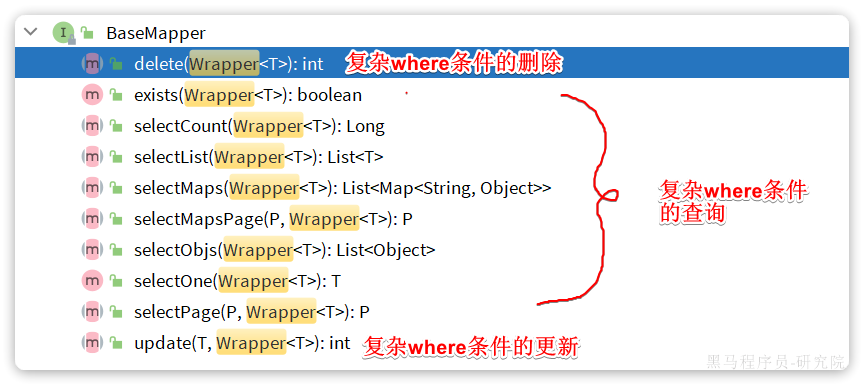
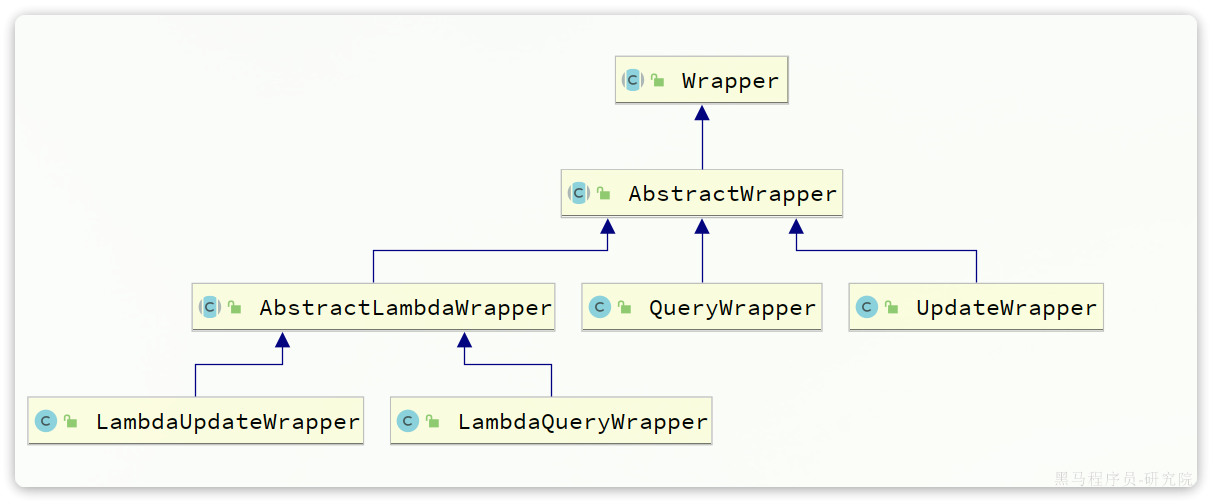
参数中的Wrapper就是条件构建的抽象类,其下有很多默认实现,继承关系如图:
Wrapper的子类AbstractWrapper提供了where中包含的所有类型条件的构建方法:
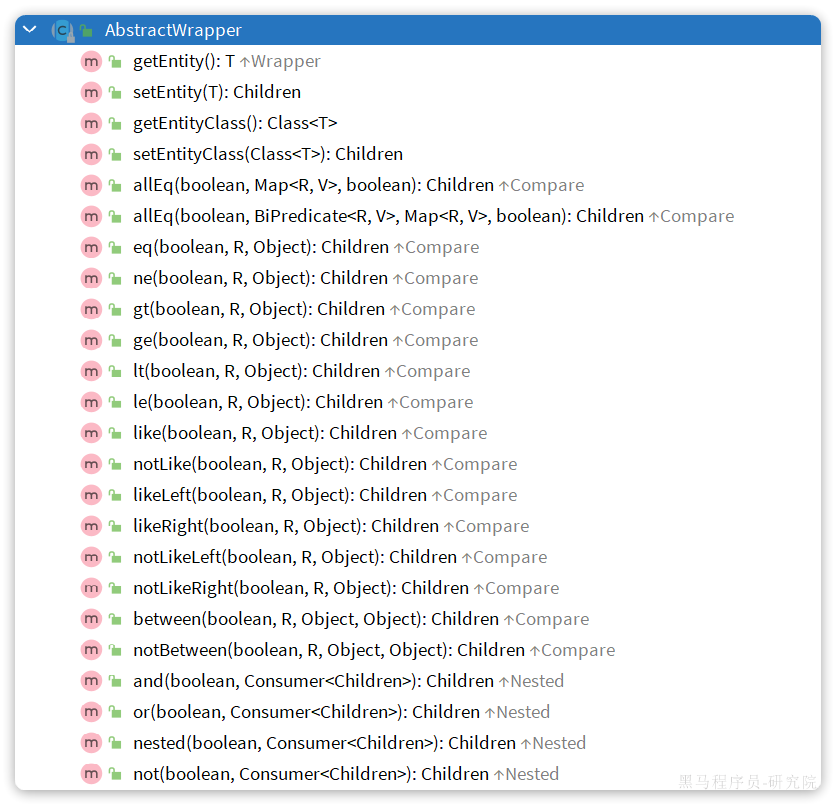
而QueryWrapper在AbstractWrapper的基础上拓展了一个select方法,允许指定查询字段:
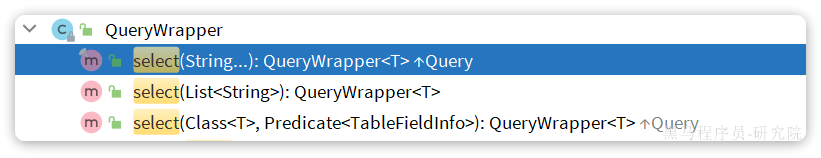
而UpdateWrapper在AbstractWrapper的基础上拓展了一个set方法,允许指定SQL中的SET部分:
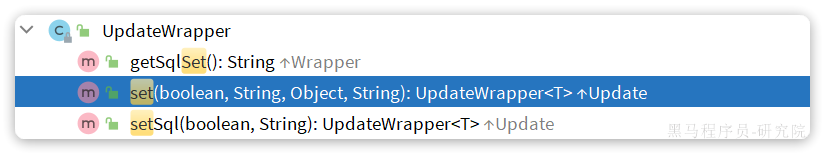
QueryWrapper
无论是查询、修改、删除,都可以使用QueryWrapper来构建条件
示例1:
- 需求:查询姓名中包含“李”且薪资大于等于5000的员工的 id, name, phone, salary字段
- SQL语句:
select id, name, phone, salary from emp where name like '%李%' and salary >= 5000; - 实现代码如下:
-
首先让EmpMapper继承自BaseMapper:
``` @Mapper public interface EmpMapper extends BaseMapper
{ } ``` 2. 其次,在测试类中注入EmpMapper,并创建条件构建器,最后使用BaseMapper的selectList方法,并传入构建器:
``` @SpringBootTest public class TestQueryWrapper {
 @Autowired
 private EmpMapper empMapper;

 @Test
 public void testQueryWrapper() {
     // 查询姓名中包含“李”且薪资大于等于5000的员工的 id, name, phone, salary字段
     QueryWrapper<Emp> queryWrapper = new QueryWrapper<>();
     queryWrapper.like("name", "李")
             .ge("salary", 5000)
             .select("id", "name", "phone", "salary");

     List<Emp> emps = empMapper.selectList(queryWrapper);
     emps.forEach(System.out::println);
 }
} ```
示例2:
- 需求:更新名为”李忠”的员工的薪水为9000
- 实现代码如下:
- 第一步和示例1一样,这里省略
-
依旧是注入EmpMapper,然后创建条件构建器,并使用BaseMapper的update方法,传入构建器:
``` @Autowired private EmpMapper empMapper;
@Test public void testUpdateByQueryWrapper() { // 更新名为"李忠"的员工的薪水为9000 Emp emp = new Emp(); emp.setSalary(9000); QueryWrapper
queryWrapper = new QueryWrapper<>(); queryWrapper.eq("name", "李忠"); empMapper.update(emp, queryWrapper); } ```
UpdateWrapper
示例:
- 需求:更新id为5, 6, 7的员工的薪水,加2000
- SQL语句:
update emp set salary = salary + 2000 where id in (5, 6, 7); - 实现代码如下:
- EmpMapper继承BaseMapper,测试类注入EmpMapper,这两步还是和QueryWrapper中的示例一样
-
具体测试方法如下:
@Test
 public void testUpdateWrapper() {
     // 更新id为5, 6, 7的员工的薪水,加2000
     UpdateWrapper<Emp> updateWrapper = new UpdateWrapper<>();
     updateWrapper.in("id", 5, 6, 7)
             .setSql("salary = salary + 2000");
     empMapper.update(updateWrapper);
 }
setSql中的参数就是SQL语句里set后面跟随的更新内容
LambdaQueryWrapper
无论是QueryWrapper还是UpdateWrapper在构造条件的时候都需要写死字段名称,这在编程规范中显然是不推荐的
那怎么样才能不写字段名,又能知道字段名呢?
其中一种办法是基于变量的**getter**方法结合反射技术来实现,因此咱们只要将条件对应的字段的getter方法传递给Mybatis-Plus,它就能计算出对应的变量名了。而传递方法可以使用JDK8中的方法引用和Lambda表达式。 因此Mybatis-Plus又提供了一套基于Lambda的Wrapper,包含两个类:
- LambdaQueryWrapper
- LambdaUpdateWrapper
分别对应QueryWrapper和UpdateWrapper
其使用方式如下:
@Test
public void testLambdaQueryWrapper() {
    // 查询姓名中包含“李”且薪资大于等于5000的员工的 id, name, phone, salary字段
    LambdaQueryWrapper<Emp> queryWrapper = new LambdaQueryWrapper<>();
    queryWrapper.like(Emp::getName, "李")
            .gt(Emp::getSalary, 5000)
            .select(Emp::getId, Emp::getName, Emp::getPhone, Emp::getSalary);

    List<Emp> emps = empMapper.selectList(queryWrapper);
    System.out.println(emps);
}

@Test
public void testLambdaUpdateWrapper() {
    // 更新id为5, 6, 7的员工的薪水,加2000
    LambdaUpdateWrapper<Emp> updateWrapper = new LambdaUpdateWrapper<>();
    updateWrapper.in(Emp::getId, 5, 6, 7)
            .setSql("salary = salary + 2000");
    empMapper.update(updateWrapper);
}
IService
MP不仅提供了Map层接口BaseMapper,还提供了通用的Service层接口以及默认实现,并在其中封装了一些常用的service模板方法。通用接口为IService,默认实现为ServiceImpl,其中封装的方法可以分为以下几类:
save:新增remove:删除update:更新get:查询单个结果list:查询集合结果count:计数page:分页查询
基本增删改查
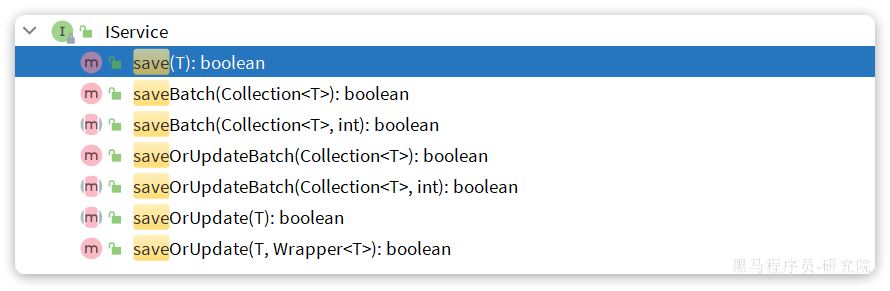
新增:
- **
save**:新增单个元素 - **
saveBatch**:批量新增 saveOrUpdate是根据id判断,如果数据存在就更新,不存在则新增saveOrUpdateBatch是批量的新增或修改
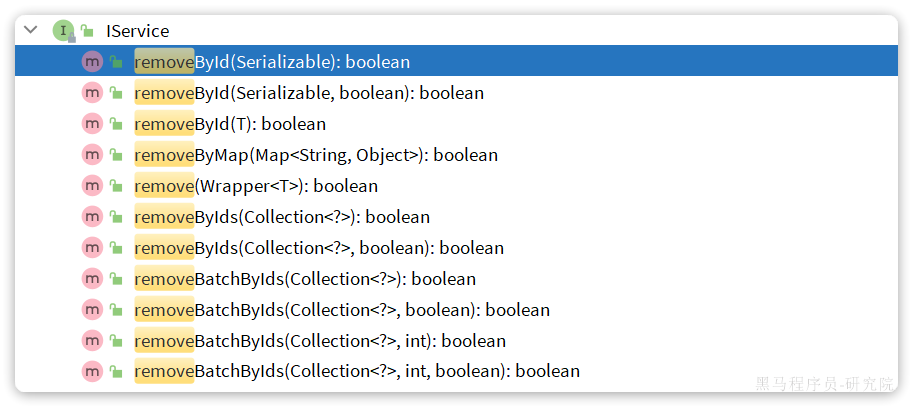
删除:
- **
removeById**:根据id删除 removeByIds:根据id批量删除removeByMap:根据Map中的键值对条件删除remove(Wrapper<T>):根据Wrapper条件删除
修改:
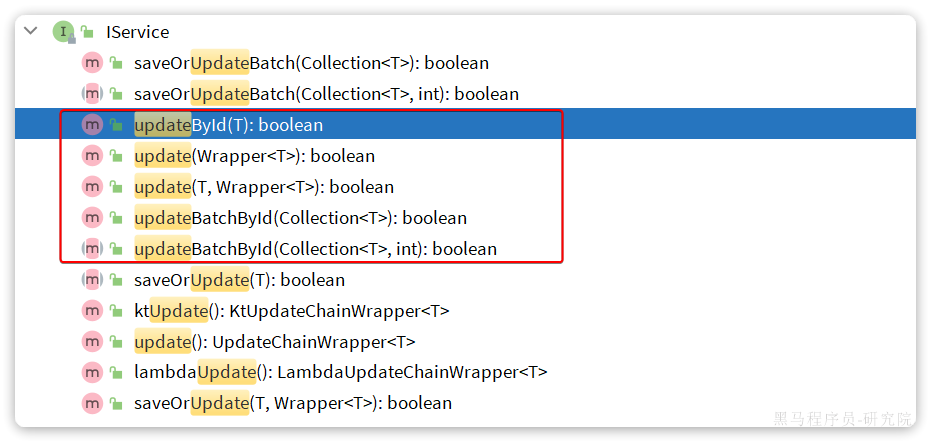
- **
updateById**:根据id修改 update(Wrapper<T>):根据UpdateWrapper修改,Wrapper中包含set和where部分update(T,Wrapper<T>):按照T内的数据修改与Wrapper匹配到的数据updateBatchById:根据id批量修改
查询单个数据:
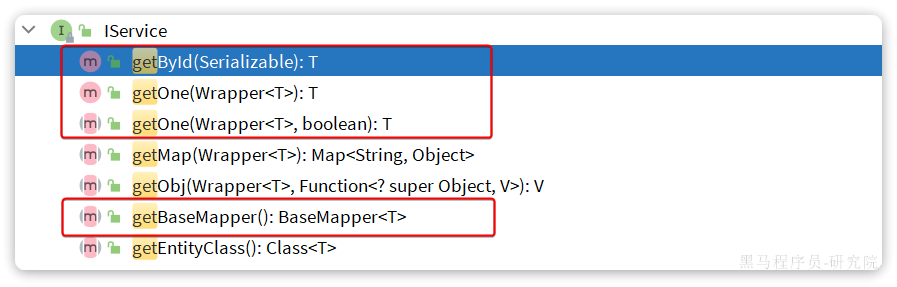
getById:根据id查询1条数据getOne(Wrapper<T>):根据Wrapper查询1条数据getBaseMapper:获取Service内的BaseMapper实现,某些时候需要直接调用Mapper内的自定义SQL时可以用这个方法获取到Mapper
查询多条数据:
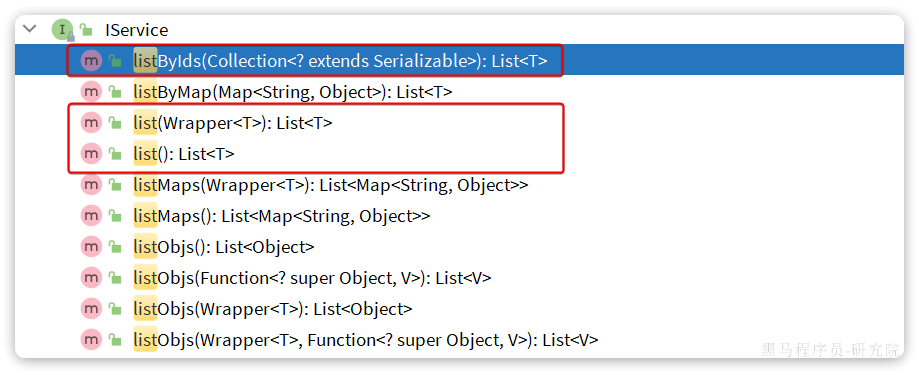
listByIds:根据id批量查询list(Wrapper<T>):根据Wrapper条件查询多条数据list():查询所有
统计数据:
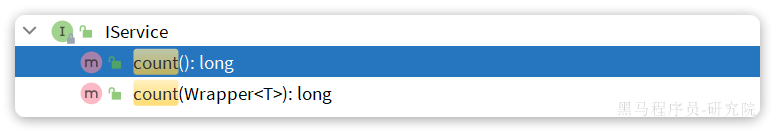
count():统计所有数量count(Wrapper<T>):统计符合Wrapper条件的数据数量
基本用法与快速入门
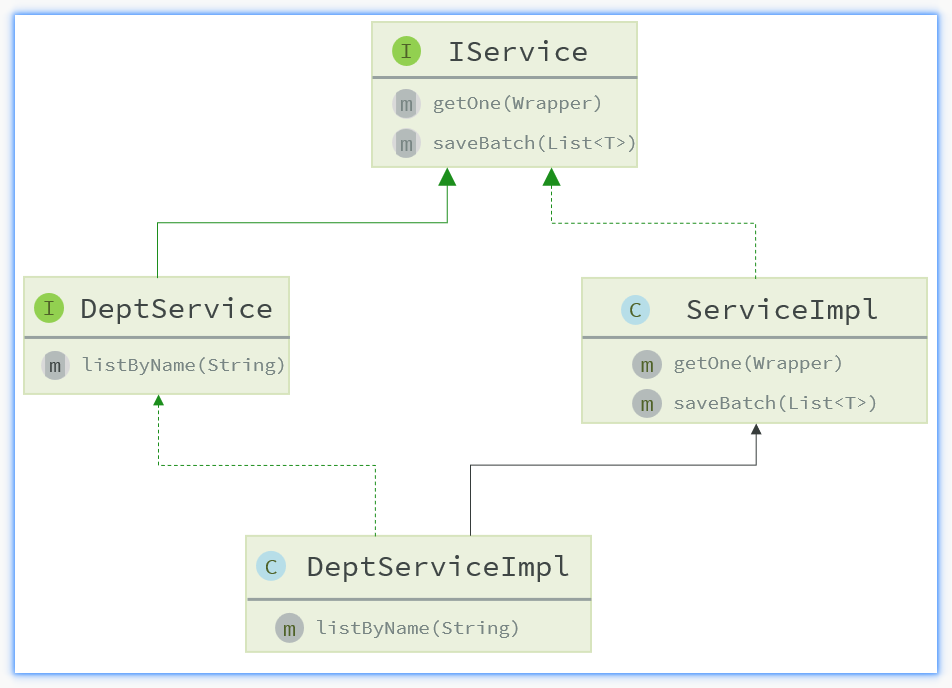
由于Service中经常需要定义与业务有关的自定义方法,因此咱们不能直接使用IService,而是自定义Service接口,然后继承IService以拓展方法。同时,让自定义的Service实现类继承ServiceImpl,这样就不用自己实现IService中的接口了
需求:基于Mybatis-Plus的 Iservice 接口,实现Tlias智能学习辅助系统部门管理页面的所有功能:
- 新增部门
- 根据id查询部门
- 根据id更新部门
- 根据id删除部门
首先,找到DeptService接口,让它继承IService接口,并在泛型上指定实体类的类型:
public interface DeptService extends IService<Dept> {

}
改完之后,原来书写的方法可以全部删除
接着,找到DeptService接口的实现类:DeptServiceImpl,让它继承自ServiceImpl类,在泛型的位置指定Mapper层接口和实体类:
@Service
public class DeptServiceImpl extends ServiceImpl<DeptMapper, Dept> implements DeptService {

}
最后,修改DeptController中报错的代码,改一下方法调用就可以正常运行了
@Slf4j
@RequestMapping("/depts")
@RestController
public class DeptController {
    @Autowired
    private DeptService deptService;

    @GetMapping
    public Result findAll() {
        log.info("查询所有部门数据");

        List<Dept> depts = deptService.list();

        return Result.success(depts);
    }

    // 删除部门
    @DeleteMapping
    public Result deleteById(Integer id) {
        log.info("根据id删除部门,删除的部门id:{}", id);
        deptService.removeById(id);
        return Result.success();
    }

    // 新增部门
    @PostMapping
    public Result save(@RequestBody Dept dept) {
        log.info("新增部门,要新增的部门信息:{}", dept);
        deptService.save(dept);
        return Result.success();
    }

    // 根据ID查询部门信息
    @GetMapping("/{id}")
    public Result getById(@PathVariable Integer id) {
        log.info("根据id查询部门,要查询的id:{}", id);

        Dept dept = deptService.getById(id);

        return Result.success(dept);
    }

    // 修改部门
    @PutMapping
    public Result update(@RequestBody Dept dept) {
        log.info("修改部门数据,修改后的部门数据:{}", dept);
        deptService.updateById(dept);
        return Result.success();
    }
}
实战
准备工作
Tlias员工管理部分,由MyBatis升级为MyBatis-Plus
由于员工管理中存在分页条件查询的功能,所以还需要使用到MP中的分页功能(PaginationInnerInterceptor)
于
v3.5.9起,PaginationInnerInterceptor已分离出来。如需使用,则需单独引入mybatis-plus-jsqlparser依赖
此时,由于项目中引入的MP依赖为3.5.11版本:
<dependency>
    <groupId>com.baomidou</groupId>
    <artifactId>mybatis-plus-spring-boot3-starter</artifactId>
    <version>3.5.11</version>
</dependency>
所以还需要单独引入mybatis-plus-jsqlparser:
<dependency>
    <groupId>com.baomidou</groupId>
    <artifactId>mybatis-plus-jsqlparser</artifactId>
    <version>3.5.11</version>
</dependency>
接下来,在项目中新建一个配置类:com.itheima.config.MybatisConfig
package com.itheima.config;

import com.baomidou.mybatisplus.annotation.DbType;
import com.baomidou.mybatisplus.extension.plugins.MybatisPlusInterceptor;
import com.baomidou.mybatisplus.extension.plugins.inner.PaginationInnerInterceptor;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class MybatisConfig {
    @Bean
    public MybatisPlusInterceptor mybatisPlusInterceptor() {
        // 初始化Mybatis-Plus核心插件
        MybatisPlusInterceptor mybatisPlusInterceptor = new MybatisPlusInterceptor();
        // 添加分页插件
        PaginationInnerInterceptor paginationInnerInterceptor = new PaginationInnerInterceptor(DbType.MYSQL);
        paginationInnerInterceptor.setMaxLimit(1000L);
        mybatisPlusInterceptor.addInnerInterceptor(paginationInnerInterceptor);

        return mybatisPlusInterceptor;
    }
}
最后一步,就是业务层的继承和实现关系:
- 首先先将EmpMapper继承BaseMapper:
@Mapper
public interface StudentMapper {

}
- 其次,再对Service的Emp进行修改,先是EmpService接口,需要继承IService接口:
public interface EmpService extends IService<Emp> {

}
- 然后对其实现类增加ServiceImpl的继承:
@Service
public class EmpServiceImpl extends ServiceImpl<EmpMapper, Emp> implements EmpService {

}
分页查询修改
在控制层中编写分页查询的接口:
@GetMapping
public Result page(EmpQueryParam param) {
    log.info("员工列表查询条件:{}", param);

    // 调用Service层查询分页数据
    PageResult<Emp> pageResult = empService.getPageResult(param);

    // 返回结果
    return Result.success(pageResult);
}
业务层代码:
@Autowired
private DeptService deptService;

@Override
public PageResult<Emp> getPageResult(EmpQueryParam param) {
    // 1. 创建分页参数对象
Page<Emp> pageParam = Page.of(param.getPage(), param.getPageSize());

    // 2. 设置排序条件
pageParam.addOrder(OrderItem.desc("update_time"));

    // 3. 执行分页查询,获取结果
Page<Emp> pageResult = page(pageParam);

    // 获取员工集合
    List<Emp> emps = page.getRecords();

    // 获取所有员工的部门id
    List<Integer> deptIds = emps.stream().map(Emp::getDeptId).collect(Collectors.toList());
    if (!deptIds.isEmpty()) {
        // 批量查询这些部门的信息
        List<Dept> depts = deptService.listByIds(deptIds);
        // 将部门名称封装到员工对象中
        emps.forEach(emp -> {
            depts.forEach(dept -> {
                if (emp.getDeptId() != null && emp.getDeptId().equals(dept.getId())) {
                    emp.setDeptName(dept.getName());
                }
            });
        });
    }

    // 封装结果并返回
    return new PageResult<>(page.getTotal(), emps);
}
原本的分页查询中,SQL语句是多表查询,但是MP不支持多表查询,所以可以拆分成两次单表查询
第一次查询emp表,将所有员工数据中的dept_id保存到集合中
第二次查询dept表,根据dept_id获取对应的部门名称,将部门名称再封装到Emp对象中
分页条件查询
page方法不仅可以传入分页参数,还可以传入构建器wrapper
page(E page, Wrapper<T> queryWrapper)
所以,在原有代码中,加入构建器并作为参数传入page就能实现分页条件查询:
@Override
public PageResult<Emp> getPageResult(EmpQueryParam param) {
    // 1. 创建分页参数对象
    Page<Emp> pageParam = Page.of(param.getPage(), param.getPageSize());

    // 2.1 设置排序条件
    pageParam.addOrder(OrderItem.desc("update_time"));

    // 2.2 添加查询条件
    LambdaQueryWrapper<Emp> queryWrapper = new LambdaQueryWrapper<>();
    queryWrapper
            .like(param.getName() != null && !param.getName().isEmpty(), Emp::getName, param.getName())
            .eq(param.getGender() != null, Emp::getGender, param.getGender())
            .between(param.getBegin() != null && param.getEnd() != null, Emp::getEntryDate, param.getBegin(), param.getEnd());

    // 3. 执行分页查询,获取结果
    Page<Emp> pageResult = page(pageParam, queryWrapper);

    // 获取员工集合
    List<Emp> emps = pageResult.getRecords();

    // 获取所有员工的部门id
    List<Integer> deptIds = emps.stream().map(Emp::getDeptId).collect(Collectors.toList());

    if (!deptIds.isEmpty()) {
        // 批量查询这些部门的信息
        List<Dept> depts = deptService.listByIds(deptIds);

        // 将部门名称封装到员工对象中
        emps.forEach(emp -> {
            depts.forEach(dept -> {
                if (emp.getDeptId() != null && emp.getDeptId().equals(dept.getId())) {
                    emp.setDeptName(dept.getName());
                }
            });
        });
    }

    // 封装结果并返回
    return new PageResult<>(pageResult.getTotal(), emps);
}