Canal
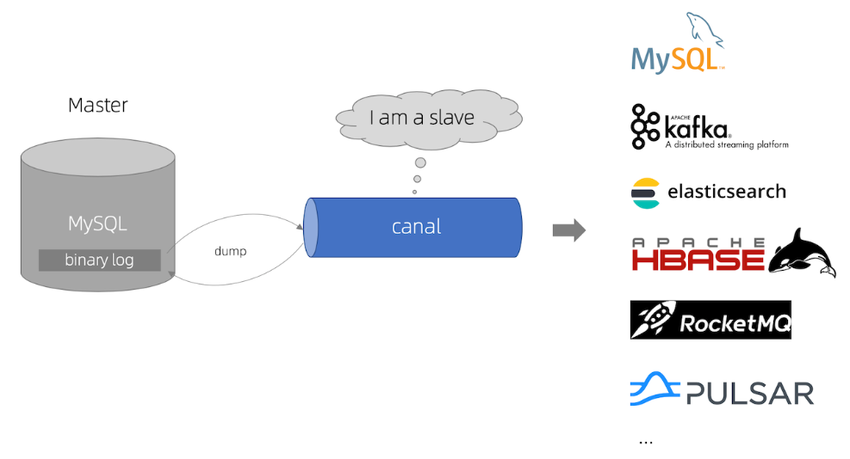
Canal的工作原理
- Canal伪装自己为MySQL的从节点,向MySQL主节点发送dump协议
- MySQL主节点一旦收到dump请求,开始推送binlog给canal
- Canal会接收并解析这些变更事件并解析binlog,并发送到其它服务器(比如es、redis等等)
环境安装
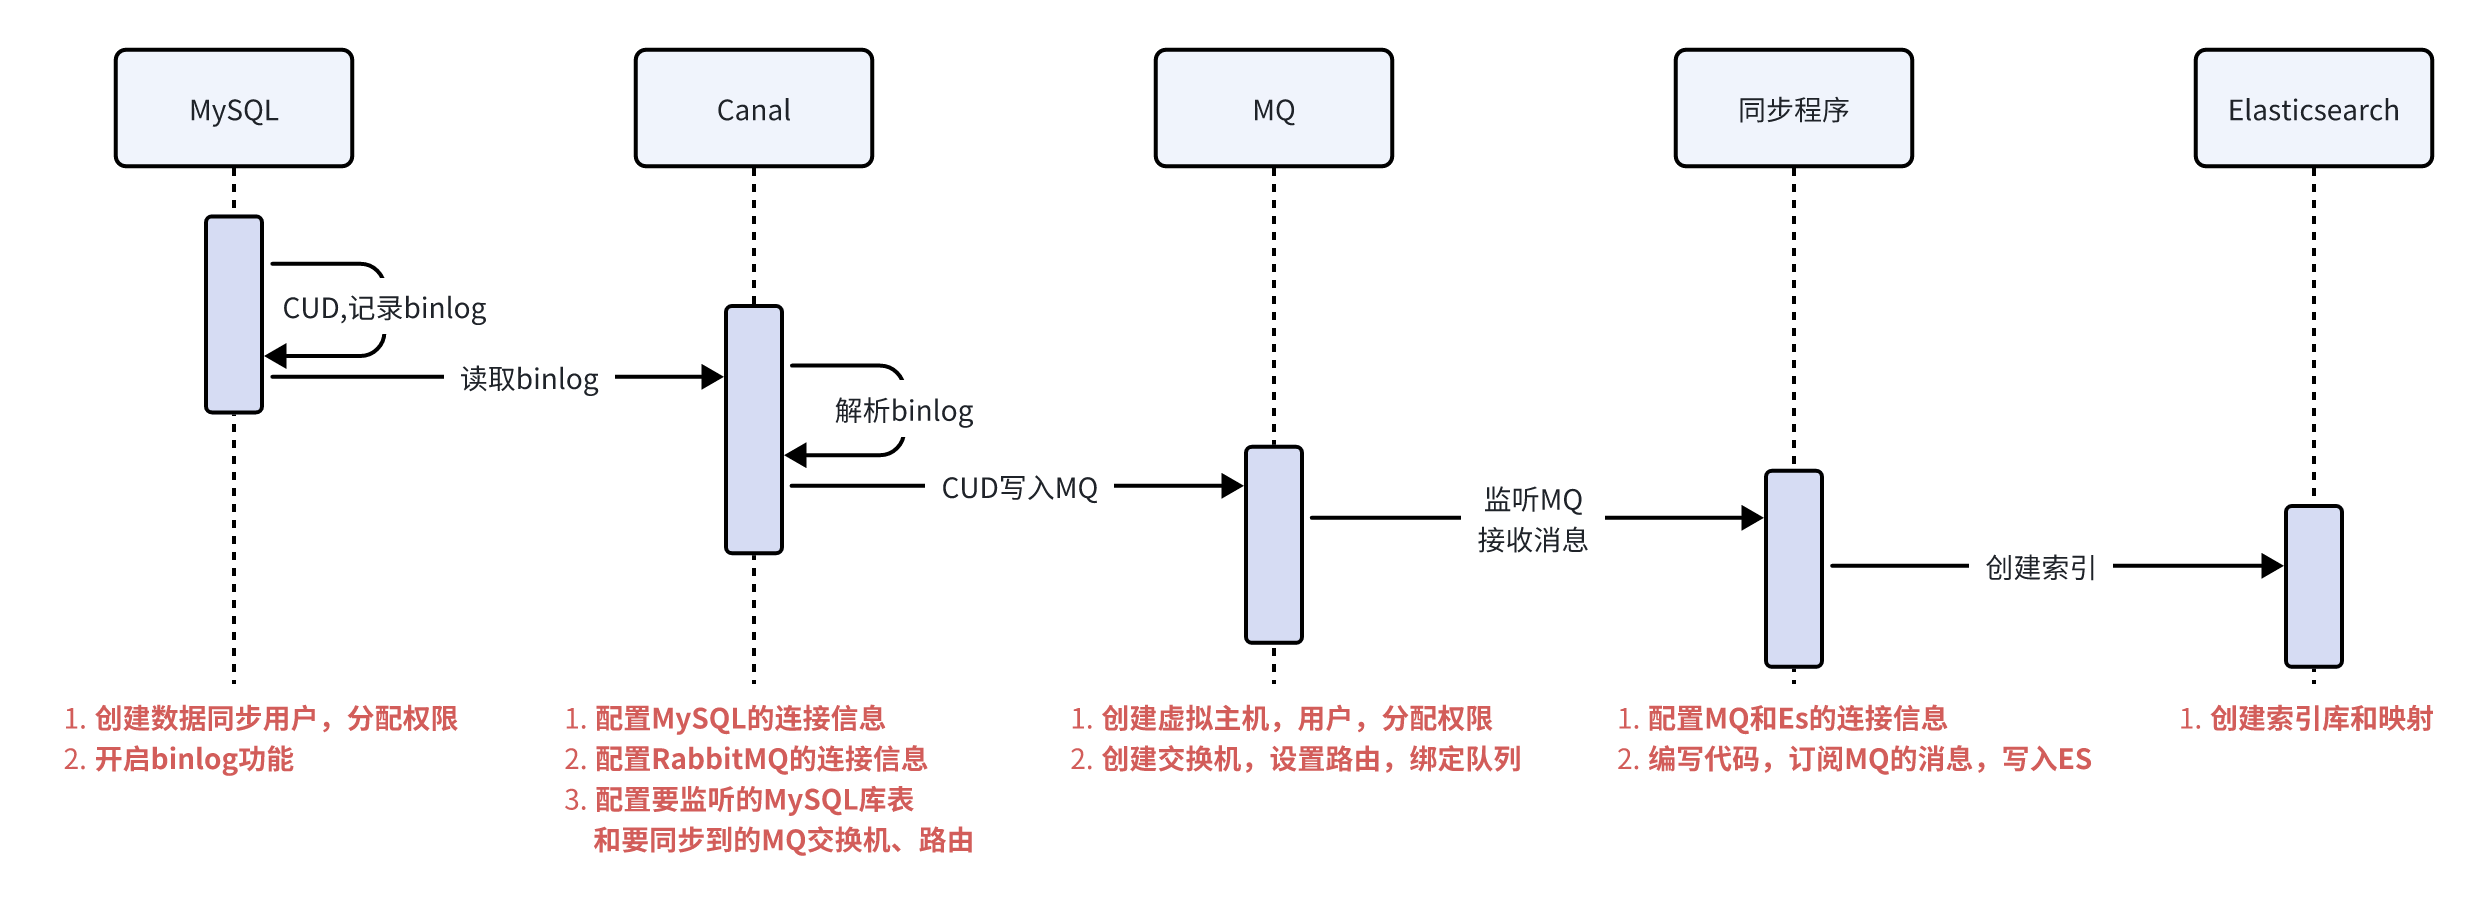
MySQL-Canal-MQ-ES的环境基本已经配置完毕
配置Mysql
- 在MySQL中需要创建一个用户,并授权
# 进入mysql容器
docker exec -it mysql /bin/bash

# 使用命令登录
mysql -u root -p

# 创建用户 用户名:canal 密码:canal
create user 'canal'@'%' identified WITH mysql_native_password by 'canal';

# 授权
# SELECT:允许用户查询(读取)数据库中的数据
# REPLICATION SLAVE:允许用户作为 MySQL 复制从库,用于同步主库的数据
# REPLICATION CLIENT: 允许用户连接到主库并获取关于主库状态的信息
GRANT SELECT,REPLICATION SLAVE,REPLICATION CLIENT ON *.* TO 'canal'@'%';
FLUSH PRIVILEGES;
- 修改MySQL配置文件/usr/mysql/conf/my.cnf,开启Binlog功能
[mysqld]
# 打开binlog
log-bin=mysql-bin
# 选择ROW(行)模式: 以行为单位记录每个被修改的行的变更
binlog-format=ROW
# 配置MySQL replaction需要定义,不要和canal的slaveId重复
server_id=1

# 只保留最近3天的日志
expire_logs_days=3
# binlog每个日志文件的大小
max_binlog_size = 100m
# binlog缓存区的大小
max_binlog_cache_size = 512m
配置文件修改完毕之后,使用下面命令重启mysql容器
docker restart mysql
- 查看当前mysql的状态
-- 查看目前的binlog模式
SHOW VARIABLES LIKE 'log_bin'; -- ON
show variables like 'binlog_format';  -- ROW

-- 查看binlog日志文件列表
SHOW BINARY LOGS;

-- 查看当前正在写入的binlog文件
SHOW MASTER STATUS;
配置RabbitMQ
给出的服务器中已经提供好了rabbitmq的软件,启动之后可以直接访问
地址:http://192.168.101.68:15672/ 账号:czri 密码:czri1234
目前虚拟机中提前准备好了内容有
- 虚拟主机:/xzb
- 虚拟主机对应的账户和密码:xzb
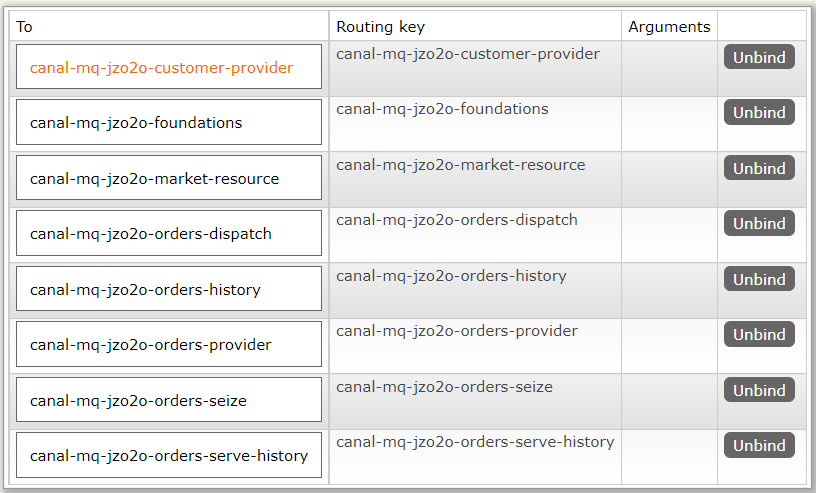
- top类型的交换机:exchange.canal-jzo2o,以及对应队列的绑定
配置Canal
Canal容器在虚拟机中已经提供好了,要做的是对其进行配置
最终达到的效果就是:操作jzo2o-foundations数据库下serve_sync表的数据后通过canal将修改信息发送到MQ
- 配置MySQL的连接信息,修改/data/soft/canal/instance.properties
# 设置要监听的mysql服务器地址
canal.instance.master.address=192.168.101.68:3306

# 设置binlog同步开始位置
canal.instance.master.journal.name=mysql-bin.000001
canal.instance.master.position=0
canal.instance.master.timestamp=
canal.instance.master.gtid=

# 从MySQL同步时,用到的账号和密码
canal.instance.dbUsername=canal
canal.instance.dbPassword=canal
- 配置RabbitMQ的连接信息,修改/data/soft/canal/canal.properties
# tcp, kafka, rocketMQ, rabbitMQ
canal.serverMode = rabbitMQ

##################################################
#########       RabbitMQ             #############
##################################################
# 下面配置分别是mq主机的地址、虚拟主机名称、交换机名称、账户、密码、持久化方式
rabbitmq.host = 192.168.101.68
rabbitmq.virtual.host = /xzb
rabbitmq.exchange = exchange.canal-jzo2o
rabbitmq.username = xzb
rabbitmq.password = xzb
rabbitmq.deliveryMode = 2
- 配置需要监听的mysql表以及同步的mq的信息,修改/data/soft/canal/instance.properties
# 需要监听的数据库的表
# canal.instance.filter.regex=数据库名称\\数据表名称
# canal.instance.filter.regex=jzo2o-foundations\\.serve_sync
canal.instance.filter.regex=
    jzo2o-orders-1\\.orders_dispatch,
    jzo2o-orders-1\\.orders_seize,
    jzo2o-foundations\\.serve_sync,
    jzo2o-customer\\.serve_provider_sync,
    jzo2o-orders-1\\.serve_provider_sync,
    jzo2o-orders-1\\.history_orders_sync,
    jzo2o-orders-1\\.history_orders_serve_sync,
    jzo2o-market\\.activity

# 需要将对应表的变化,通知到交换机哪个routingKey上
# canal.mq.dynamicTopic=交换机的routingKey:监听的数据库和表
# canal.mq.dynamicTopic=canal-mq-jzo2o-foundations:jzo2o-foundations\\.serve_sync
canal.mq.dynamicTopic=
    canal-mq-jzo2o-orders-dispatch:jzo2o-orders-1\\.orders_dispatch,
    canal-mq-jzo2o-orders-seize:jzo2o-orders-1\\.orders_seize,
    canal-mq-jzo2o-foundations:jzo2o-foundations\\.serve_sync,
    canal-mq-jzo2o-customer-provider:jzo2o-customer\\.serve_provider_sync,
    canal-mq-jzo2o-orders-provider:jzo2o-orders-1\\.serve_provider_sync,
    canal-mq-jzo2o-orders-serve-history:jzo2o-orders-1\\.history_orders_serve_sync,
    canal-mq-jzo2o-orders-history:jzo2o-orders-1\\.history_orders_sync,
    canal-mq-jzo2o-market-resource:jzo2o-market\\.activity
测试MySQL-Canal-MQ
在测试之前,需要将binlog日志重置一下,以方便canal从mysql-bin.000001文件开始读取内容
- 重置MySQL的binlog
-- 重置mysql主节点,它会删除所有的binlog,然后重新从000001号开始记录日志
reset master;

-- 查看结果显示 mysql-bin.000001为正常
show master status;
- 删除meta.dat文件,重启canal
-- 停止docker
docker stop canal

-- 删除meta.dat文件(此文件是用于存储canal读取mysql中binlog的偏移量)
rm -rf /data/soft/canal/conf/meta.dat

-- 启动canal
docker start canal
安装ES
目前已经将数据同步到了MQ中,接下来编写一个程序从mq中监听数据,然后写入到es中
在这个es中已经创建好了对应的索引库serve_aggregation,结构如下
PUT /serve_aggregation
{
   "mappings" : {
      "properties" : {
        "city_code" : {
          "type" : "keyword"
        },
        "detail_img" : {
          "type" : "text",
          "index" : false
        },
        "hot_time_stamp" : {
          "type" : "long"
        },
        "id" : {
          "type" : "keyword"
        },
        "is_hot" : {
          "type" : "short"
        },
        "price" : {
          "type" : "double"
        },
        "serve_item_icon" : {
          "type" : "text",
          "index" : false
        },
        "serve_item_id" : {
          "type" : "keyword"
        },
        "serve_item_img" : {
          "type" : "text",
          "index" : false
        },
        "serve_item_name" : {
          "type" : "text",
          "analyzer": "ik_max_word",
          "search_analyzer":"ik_smart"
        },
        "serve_item_sort_num" : {
          "type" : "short"
        },
        "serve_type_icon" : {
          "type" : "text",
          "index" : false
        },
        "serve_type_id" : {
          "type" : "keyword"
        },
        "serve_type_img" : {
          "type" : "text",
          "index" : false
        },
        "serve_type_name" : {
          "type" : "text",
          "analyzer": "ik_max_word",
          "search_analyzer":"ik_smart"
        },
        "serve_type_sort_num" : {
          "type" : "short"
        }
      }
    }
}
启动虚拟机中的kibana软件
docker start kibana7.17.7
然后使用下面地址访问kibana
最后查看目前的索引库信息
# 查看索引库
GET /serve_aggregation

# 查看索引库中的数据
GET /serve_aggregation/_search
{
  "query": {
    "match_all": {}
  }
}

# 查看 1686352662791016449记录
GET /serve_aggregation/_doc/1686352662791016449
编写同步程序
- 在foundations工程添加下边的依赖
 <dependency>
    <groupId>com.jzo2o</groupId>
    <artifactId>jzo2o-canal-sync</artifactId>
</dependency>
<dependency>
    <groupId>com.jzo2o</groupId>
    <artifactId>jzo2o-es</artifactId>
</dependency>
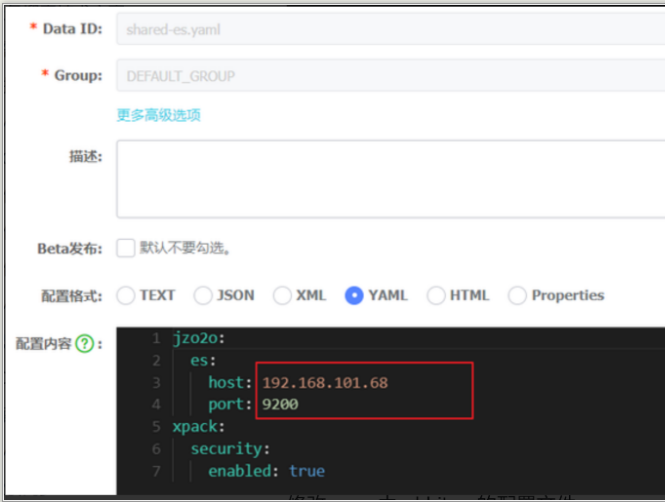
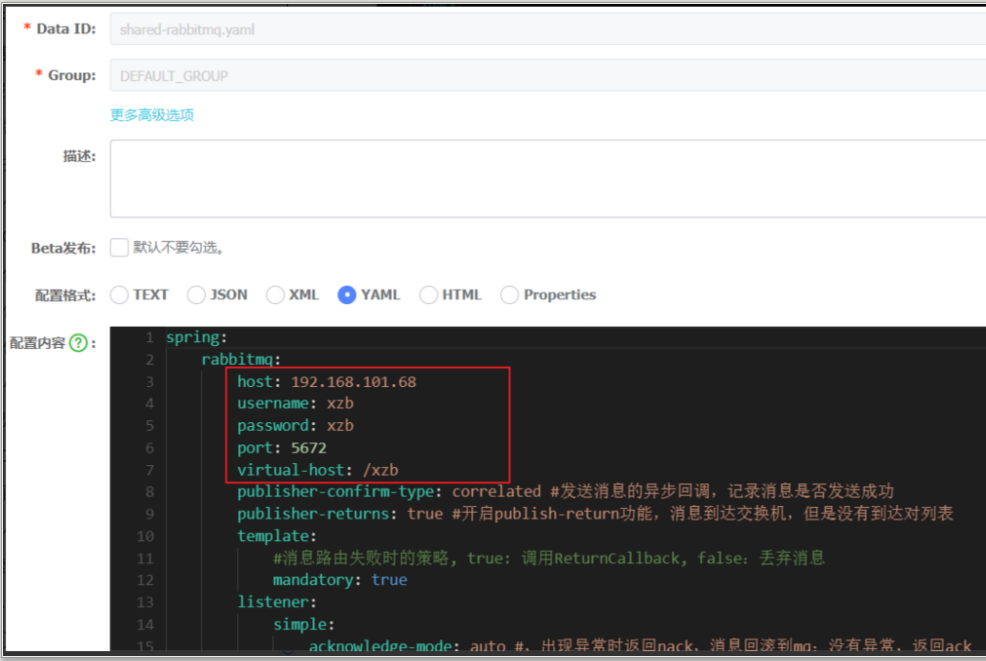
- 修改foundations的配置文件,连接es和mq
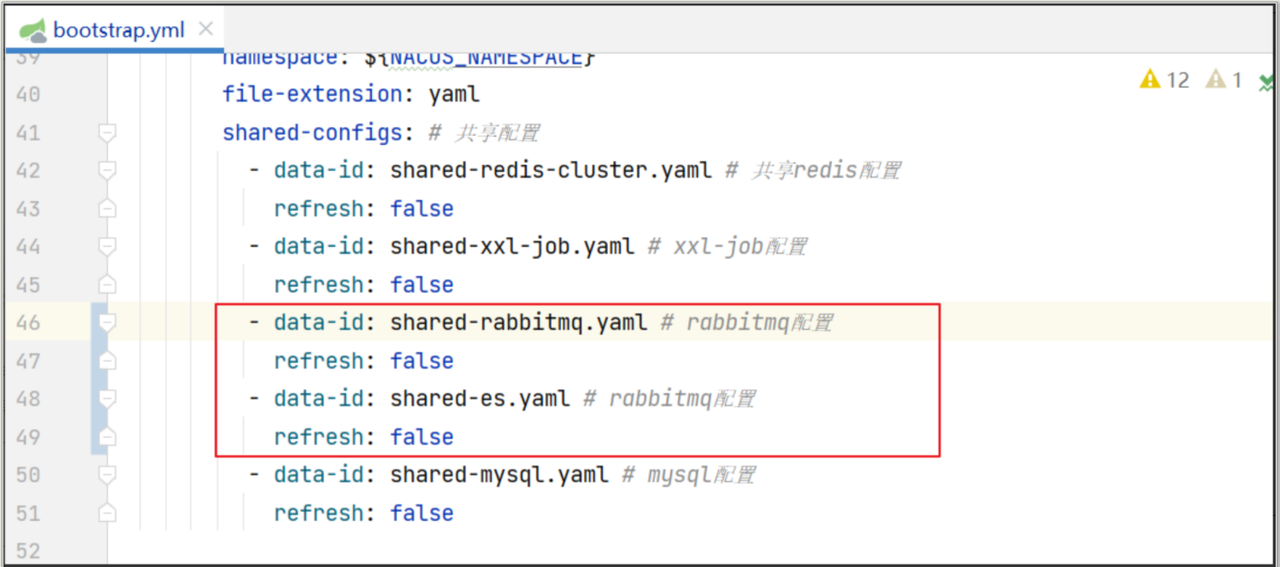
- 修改nacos中es的配置
- 修改nacos中rabbitmq的配置
- 实现数据同步
在jzo2o-foundations模块中添加com.jzo2o.foundations.handler.ServeCanalDataSyncHandler
负责监听mq,然后将消息同步到es中
package com.jzo2o.foundations.handler;

import com.jzo2o.canal.listeners.AbstractCanalRabbitMqMsgListener;
import com.jzo2o.es.core.ElasticSearchTemplate;
import com.jzo2o.foundations.constants.IndexConstants;
import com.jzo2o.foundations.model.domain.ServeSync;
import org.springframework.amqp.core.ExchangeTypes;
import org.springframework.amqp.core.Message;
import org.springframework.amqp.rabbit.annotation.*;
import org.springframework.stereotype.Component;

import javax.annotation.Resource;
import java.util.List;

//本类负责解析MQ中同步的serve_sync这张表的数据,然后写入到ES的serve_aggregation索引库
//后面相似的类有很多,例如order_sync、user_sync, 每个类中所做事情的步骤是一样的
//1. 解析MQ中的消息内容,封装到实体类对象(所有类中的这部分代码是一样的)
//2. 将实体类对象的数据同步到ES索引库中(每个类中这部分代码是不一样的)
@Component
public class ServeCanalDataSyncHandler extends AbstractCanalRabbitMqMsgListener<ServeSync> {

    @Resource
    private ElasticSearchTemplate elasticSearchTemplate;

    //此方法会接收到到来自mq的消息,然后按照解析消息、同步索引库的步骤执行
    @RabbitListener(bindings = @QueueBinding(
            value = @Queue(name = "canal-mq-jzo2o-foundations",
                    arguments = {
                            @Argument(name = "x-single-active-consumer", value = "true", type = "java.lang.Boolean")
                    }),
            exchange = @Exchange(name = "exchange.canal-jzo2o", type = ExchangeTypes.TOPIC),
            key = "canal-mq-jzo2o-foundations")
    )
    public void onMessage(Message message) throws Exception {
        //由于解析逻辑,所有子类的逻辑是一样的,索引自己放到父类中,此处直接调用父类的解析方法
        parseMsg(message);
    }

    //由于不同的子类实现逻辑不一样,因此每个子类自己实现此方法
    @Override
    public void batchSave(List<ServeSync> data) {
        //保存数据到ES指定的索引库
        elasticSearchTemplate.opsForDoc().batchInsert(IndexConstants.SERVE, data);
    }

    //由于不同的子类实现逻辑不一样,因此每个子类自己实现此方法
    @Override
    public void batchDelete(List<Long> ids) {
        //删除ES指定的索引库中的数据
        elasticSearchTemplate.opsForDoc().batchDelete(IndexConstants.SERVE, ids);
    }
}
模版方法设计模式
适用场景:
一个功能的完成需要一系列的步骤,这些步骤是固定的,但是某些步骤的具体实现是待定的
比如:老师和学生在上午的经历步骤是一样的,都是吃早饭、工作、吃午饭
但是其中工作的内容是不一样的,老师的工作是讲课,学生的工作是学习
实现流程:
- 定义一个抽象类作为父类,在父类中提供模版方法
- 在模板方法中定义出流程的步骤,能确定的行为直接写出,不能确定的行为定义为抽象方法
- 根据不同的行为定义不同的子类,继承抽象类,重写父类的抽象方法,完成各自的行为内容
许可协议:
CC BY 4.0