ElasticSearch
前情提要
黑马商城作为一个电商项目,商品的搜索肯定是访问频率最高的页面之一。目前搜索功能是基于数据库的模糊搜索来实现的,存在很多问题
首先,查询效率较低
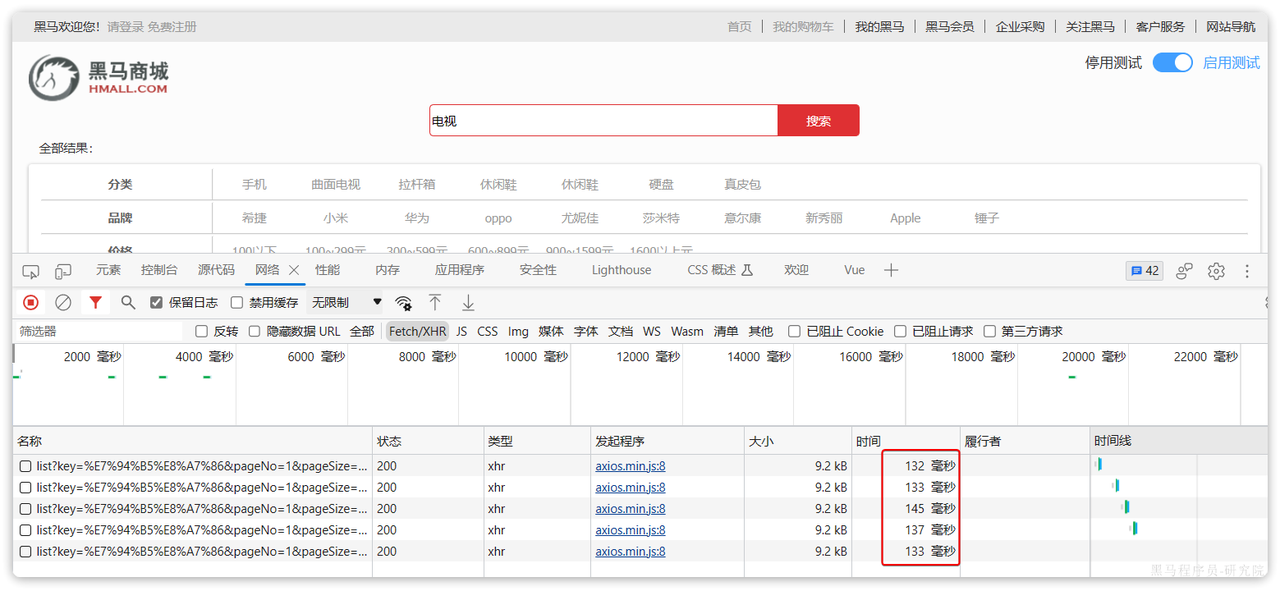
由于数据库模糊查询不走索引,在数据量较大的时候,查询性能很差。黑马商城的商品表中仅仅有不到9万条数据,基于数据库查询时,搜索接口的表现如图:
改为基于搜索引擎后,查询表现如下:
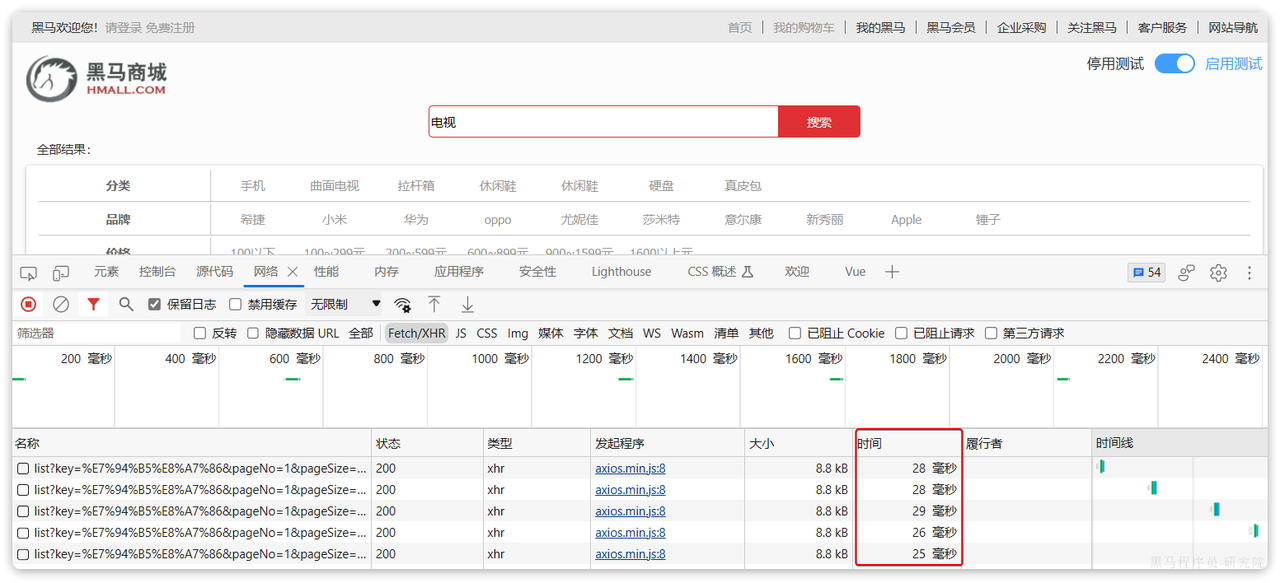
需要注意的是,数据库模糊查询随着表数据量的增多,查询性能的下降会非常明显,而搜索引擎的性能则不会随着数据增多而下降太多。目前仅10万不到的数据量差距就如此明显,如果数据量达到百万、千万、甚至上亿级别,这个性能差距会非常夸张。
其次,功能单一
数据库的模糊搜索功能单一,匹配条件非常苛刻,必须恰好包含用户搜索的关键字。而在搜索引擎中,用户输入出现个别错字,或者用拼音搜索、同义词搜索都能正确匹配到数据。
综上,在面临海量数据的搜索,或者有一些复杂搜索需求的时候,推荐使用专门的搜索引擎来实现搜索功能。
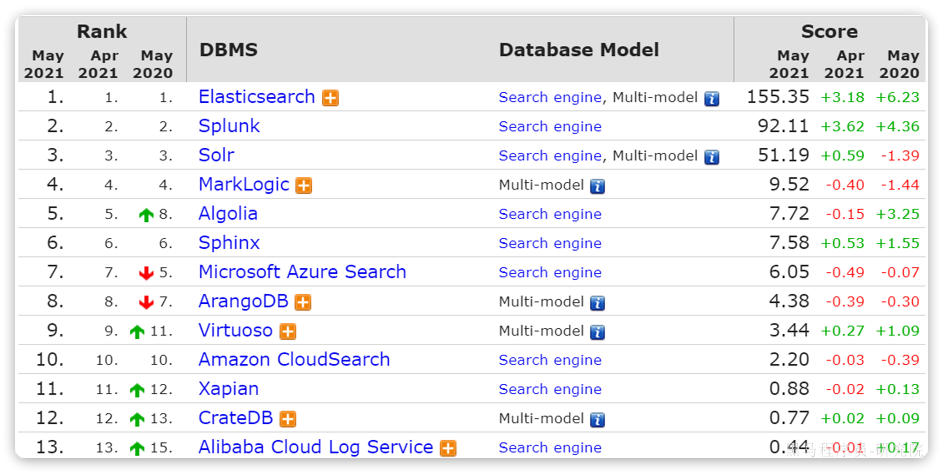
目前全球的搜索引擎技术排名如下:
初识elasticsearch
Elasticsearch的官方网站如下:Elasticsearch:官方分布式搜索和分析引擎 | Elastic
认识和安装
Elasticsearch是由elastic公司开发的一套搜索引擎技术,它是elastic技术栈中的一部分。完整的技术栈包括:
- Elasticsearch:用于数据存储、计算和搜索
- Logstash/Beats:用于数据收集
- Kibana:用于数据可视化
整套技术栈被称为ELK,经常用来做日志收集、系统监控和状态分析等等:
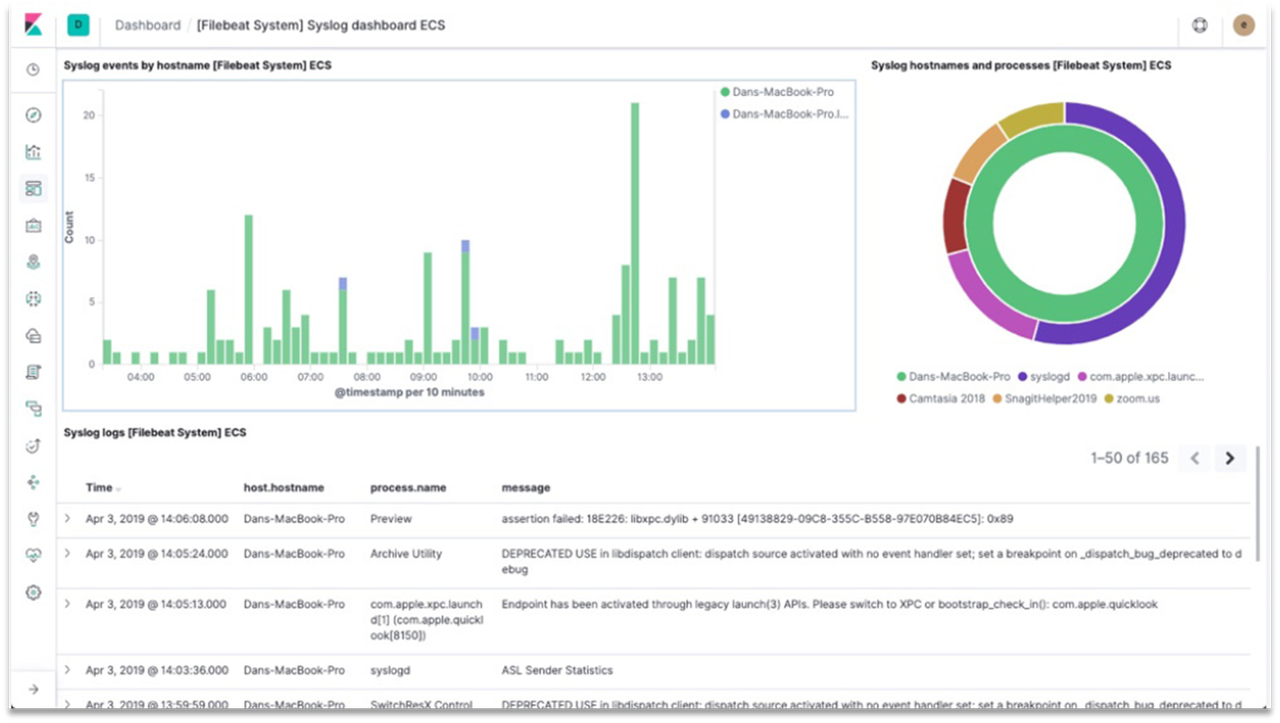
整套技术栈的核心就是用来存储、搜索、计算的Elasticsearch
要安装的内容包含2部分:
- elasticsearch:存储、搜索和运算
- kibana:图形化展示
首先Elasticsearch不用多说,是提供核心的数据存储、搜索、分析功能的
然后是Kibana,Elasticsearch对外提供的是Restful风格的API,任何操作都可以通过发送http请求来完成。不过http请求的方式、路径、还有请求参数的格式都有严格的规范,因此要借助于Kibana这个服务
Kibana是elastic公司提供的用于操作Elasticsearch的可视化控制台。它的功能非常强大,包括:
- 对Elasticsearch数据的搜索、展示
- 对Elasticsearch数据的统计、聚合,并形成图形化报表、图形
- 对Elasticsearch的集群状态监控
- 它还提供了一个开发控制台(DevTools),在其中对Elasticsearch的Restful的API接口提供了语法提示
安装elasticsearch
通过下面的Docker命令即可安装单机版本的elasticsearch:
docker run -d \
  --name es \
  -e "ES_JAVA_OPTS=-Xms512m -Xmx512m" \
  -e "discovery.type=single-node" \
  -v es-data:/usr/share/elasticsearch/data \
  -v es-plugins:/usr/share/elasticsearch/plugins \
  --privileged \
  --network hm-net \
  -p 9200:9200 \
  -p 9300:9300 \
  elasticsearch:7.12.1
注意,这里采用的是elasticsearch的7.12.1版本,由于8以上版本的JavaAPI变化很大,在企业中应用并不广泛,企业中应用较多的还是8以下的版本
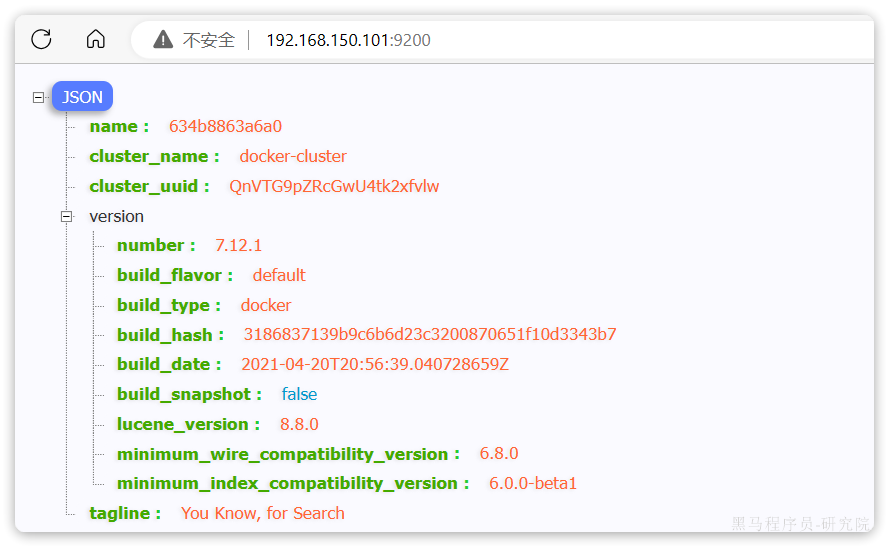
安装完成后,访问9200端口,即可看到响应的Elasticsearch服务的基本信息:
安装Kibana
通过下面的Docker命令,即可部署Kibana:
docker run -d \
--name kibana \
-e ELASTICSEARCH_HOSTS=http://es:9200 \
--network=hm-net \
-p 5601:5601  \
kibana:7.12.1
安装完成后,直接访问5601端口,即可看到控制台页面:
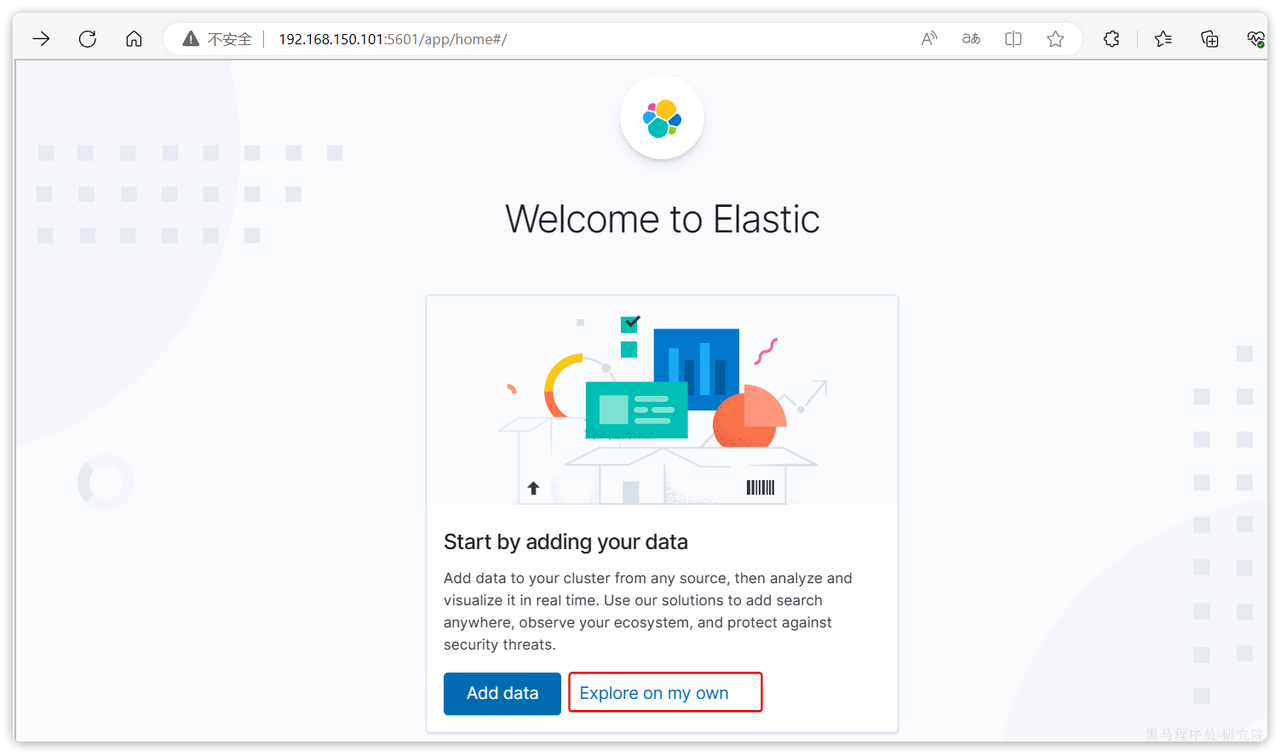
选择Explore on my own之后,进入主页面:
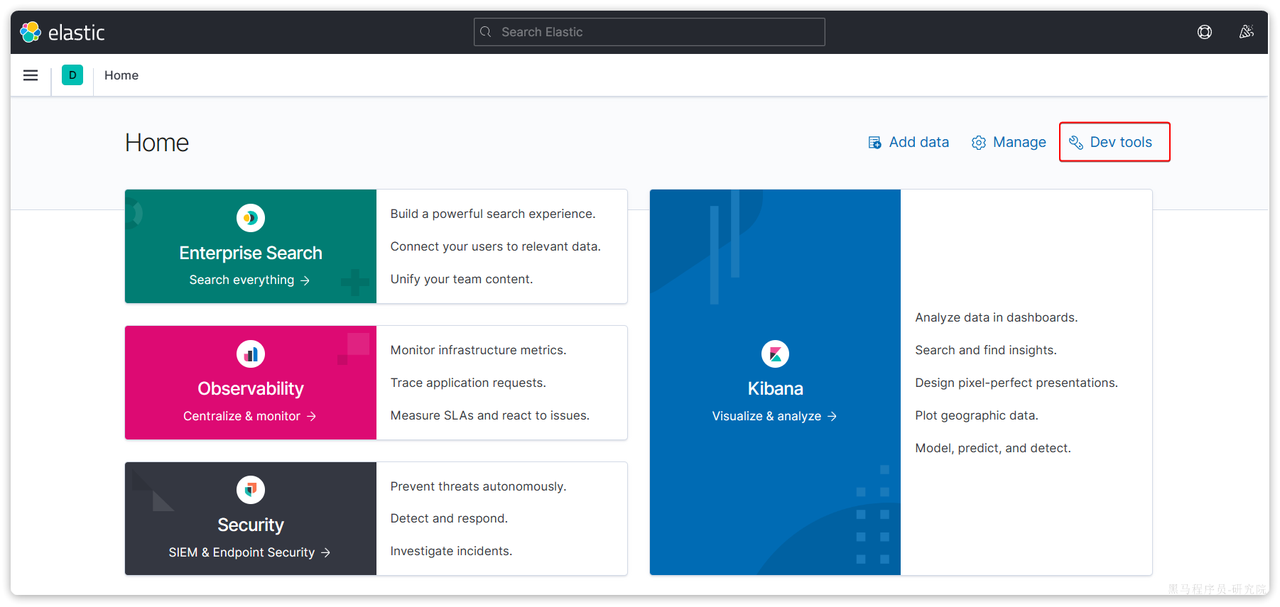
然后选中Dev tools,进入开发工具页面:
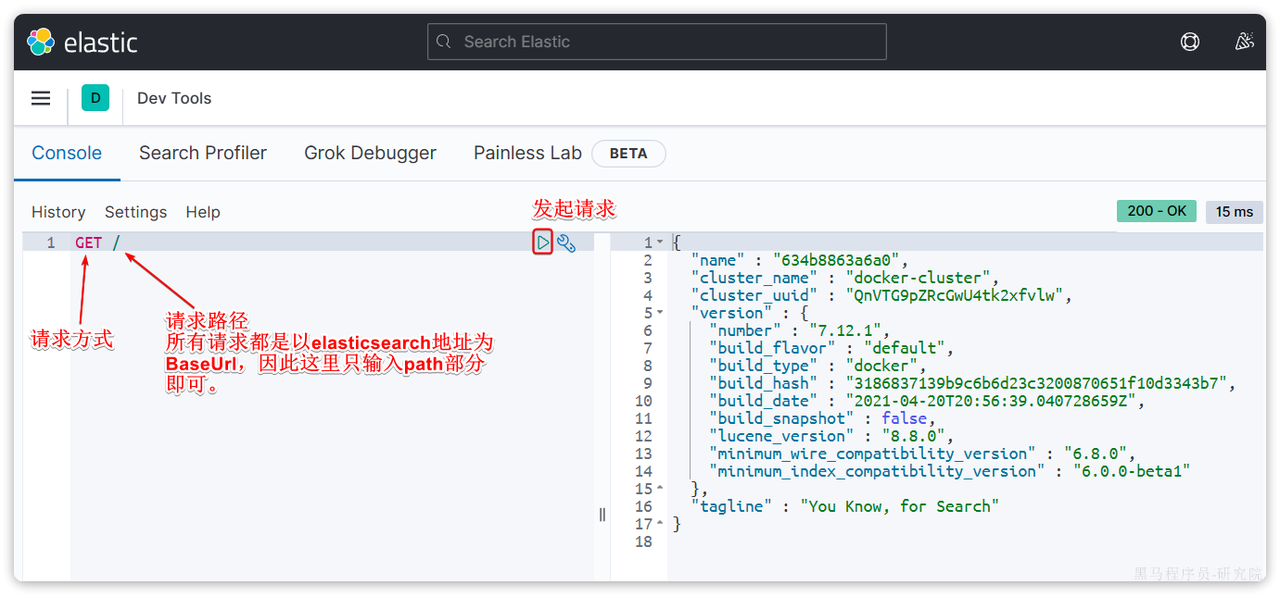
倒排索引
elasticsearch之所以有如此高性能的搜索表现,正是得益于底层的倒排索引技术
倒排索引的概念是基于MySQL这样的正向索引而言的
正向索引
先来回顾一下正向索引
例如有一张名为tb_goods的表:
| id | title | price |
|---|---|---|
| 1 | 小米手机 | 3499 |
| 2 | 华为手机 | 4999 |
| 3 | 华为小米充电器 | 49 |
| 4 | 小米手环 | 49 |
| … | … | … |
其中的id字段已经创建了索引,由于索引底层采用了B+树结构,因此我们根据id搜索的速度会非常快。但是其他字段例如title,只在叶子节点上存在。
因此要根据title搜索的时候只能遍历树中的每一个叶子节点,判断title数据是否符合要求。
比如用户的SQL语句为:
select * from tb_goods where title like '%手机%';
那搜索的大概流程如图:
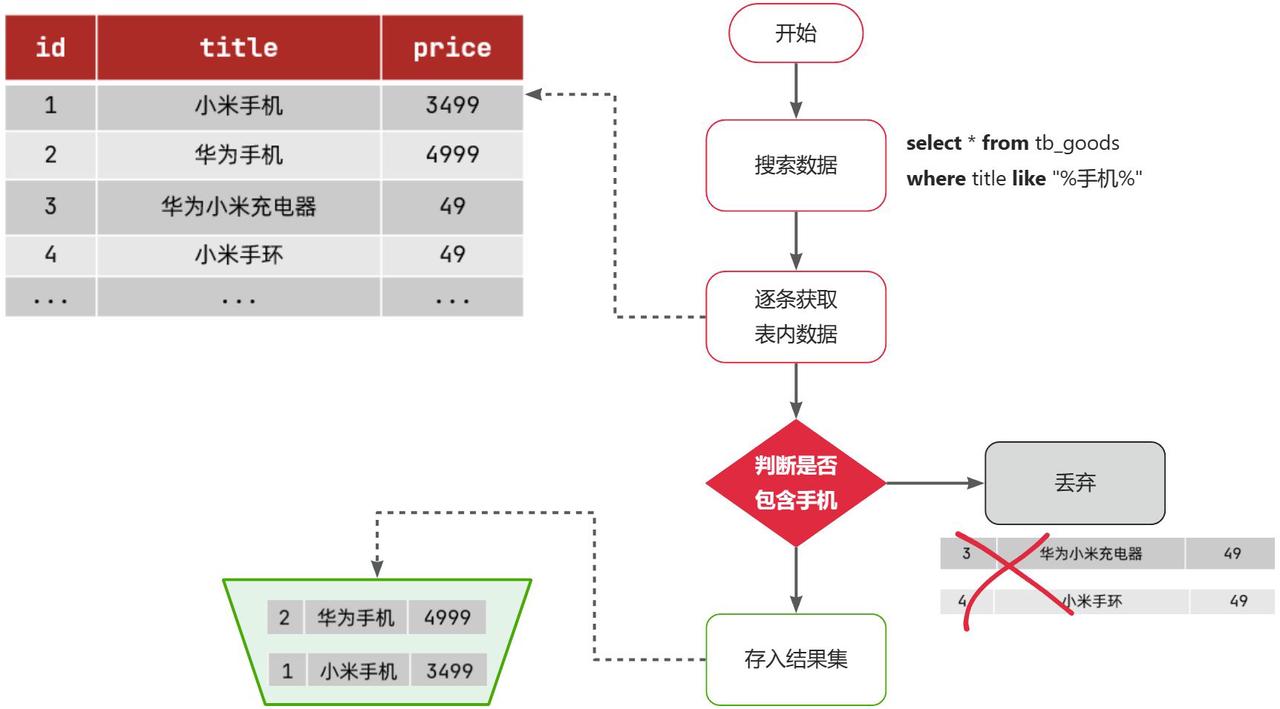
说明:
- 1)检查到搜索条件为
like '%手机%',需要找到title中包含手机的数据 - 2)逐条遍历每行数据(每个叶子节点),比如第1次拿到
id为1的数据 - 3)判断数据中的
title字段值是否符合条件 - 4)如果符合则放入结果集,不符合则丢弃
- 5)回到步骤1
倒排索引
倒排索引中有两个非常重要的概念:
- 文档(
Document):用来搜索的数据,其中的每一条数据就是一个文档。例如一个网页、一个商品信息 - 词条(
Term):对文档数据或用户搜索数据,利用某种算法分词,得到的具备含义的词语就是词条。例如:我是中国人,就可以分为:我、是、中国人、中国、国人这样的几个词条
创建倒排索引是对正向索引的一种特殊处理和应用,流程如下:
- 将每一个文档的数据利用分词算法根据语义拆分,得到一个个词条
- 创建表,每行数据包括词条、词条所在文档id、位置等信息
- 因为词条唯一性,可以给词条创建正向索引
此时形成的这张以词条为索引的表,就是倒排索引表,两者对比如下:
正向索引
| id(索引) | title | price |
|---|---|---|
| 1 | 小米手机 | 3499 |
| 2 | 华为手机 | 4999 |
| 3 | 华为小米充电器 | 49 |
| 4 | 小米手环 | 49 |
| … | … | … |
倒排索引
| 词条(索引) | 文档id |
|---|---|
| 小米 | 1,3,4 |
| 手机 | 1,2 |
| 华为 | 2,3 |
| 充电器 | 3 |
| 手环 | 4 |
倒排索引的搜索流程如下(以搜索”华为手机”为例),如图:
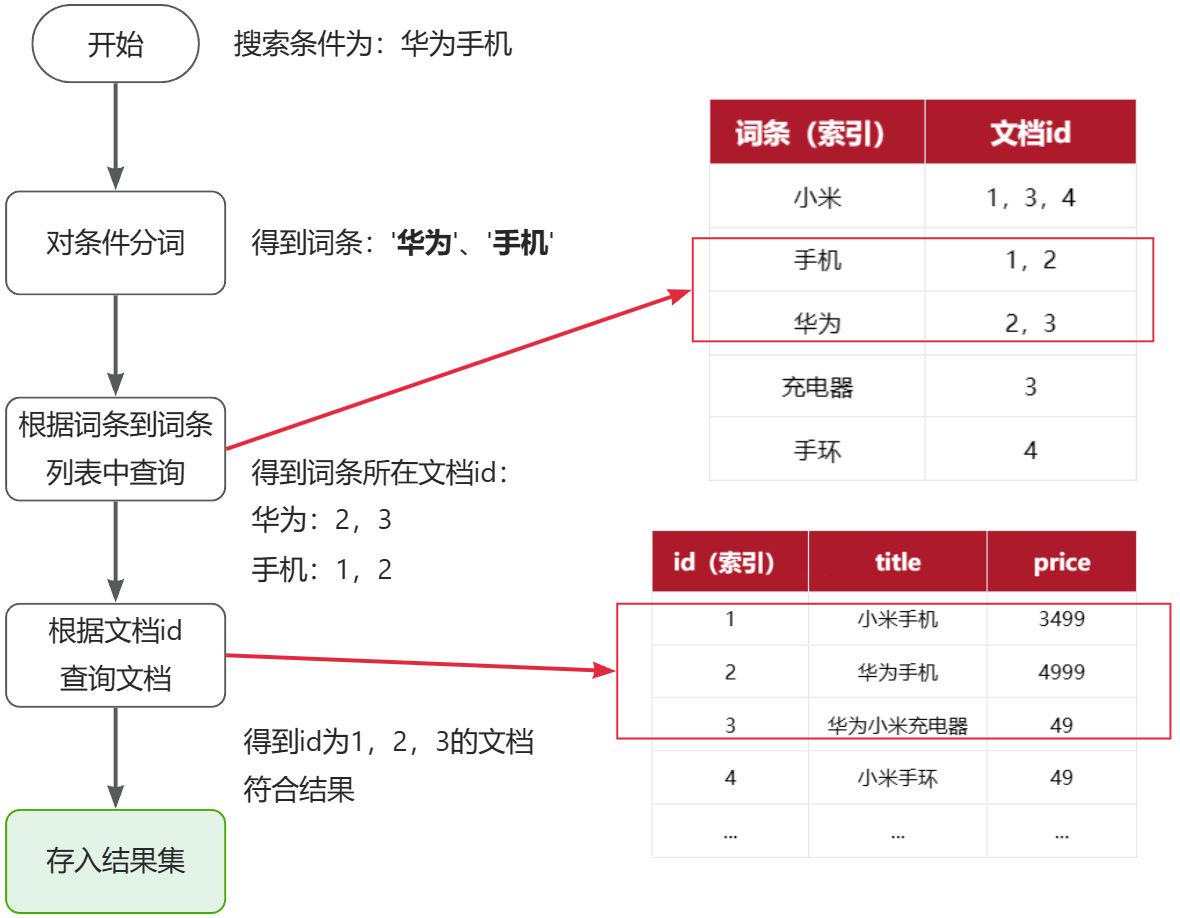
流程描述:
1)用户输入条件"华为手机"进行搜索
2)对用户输入条件分词,得到词条:华为、手机
3)拿着词条在倒排索引中查找(由于词条有索引,查询效率很高),即可得到包含词条的文档id:1、2、3
4)拿着文档id到正向索引中查找具体文档即可(由于id也有索引,查询效率也很高)
虽然要先查询倒排索引,再查询倒排索引,但是无论是词条、还是文档id都建立了索引,查询速度非常快!无需全表扫描
正向和倒排
- 正向索引是最传统的,根据id索引的方式。但根据词条查询时,必须先逐条获取每个文档,然后判断文档中是否包含所需要的词条,是根据文档找词条的过程
- 而倒排索引则相反,是先找到用户要搜索的词条,根据词条得到保护词条的文档的id,然后根据id获取文档。是根据词条找文档的过程
两者方式的优缺点:
正向索引:
- 优点:
- 可以给多个字段创建索引
- 根据索引字段搜索、排序速度非常快
- 缺点:
- 根据非索引字段,或者索引字段中的部分词条查找时,只能全表扫描。
倒排索引:
- 优点:
- 根据词条搜索、模糊搜索时,速度非常快
- 缺点:
- 只能给词条创建索引,而不是字段
- 无法根据字段做排序
IK分词器
Elasticsearch的关键就是倒排索引,而倒排索引依赖于对文档内容的分词,而分词则需要高效、精准的分词算法,IK分词器就是这样一个中文分词算法
安装IK分词器
方案一:在线安装
运行一个命令即可:
docker exec -it es ./bin/elasticsearch-plugin install https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v7.12.1/elasticsearch-analysis-ik-7.12.1.zip
然后重启es容器:
docker restart es
方案二:离线安装
如果网速较差,也可以选择离线安装。
首先,查看之前安装的Elasticsearch容器的plugins数据卷目录:
docker volume inspect es-plugins
结果如下:
[
    {
        "CreatedAt": "2024-11-06T10:06:34+08:00",
        "Driver": "local",
        "Labels": null,
        "Mountpoint": "/var/lib/docker/volumes/es-plugins/_data",
        "Name": "es-plugins",
        "Options": null,
        "Scope": "local"
    }
]
可以看到elasticsearch的插件挂载到了/var/lib/docker/volumes/es-plugins/_data这个目录
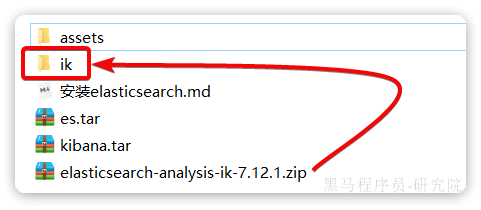
找到课前资料提供的ik分词器插件,课前资料提供了7.12.1版本的ik分词器压缩文件,对其解压:
使用IK分词器
IK分词器包含两种模式:
ik_smart:智能语义切分ik_max_word:最细粒度切分
在Kibana的DevTools上来测试分词器,首先测试Elasticsearch官方提供的标准分词器:
POST /_analyze
{
  "analyzer": "standard",
  "text": "黑马程序员学习java太棒了"
}
结果如下:
{
  "tokens" : [
    {
      "token" : "黑",
      "start_offset" : 0,
      "end_offset" : 1,
      "type" : "<IDEOGRAPHIC>",
      "position" : 0
    },
    {
      "token" : "马",
      "start_offset" : 1,
      "end_offset" : 2,
      "type" : "<IDEOGRAPHIC>",
      "position" : 1
    },
    {
      "token" : "程",
      "start_offset" : 2,
      "end_offset" : 3,
      "type" : "<IDEOGRAPHIC>",
      "position" : 2
    },
    {
      "token" : "序",
      "start_offset" : 3,
      "end_offset" : 4,
      "type" : "<IDEOGRAPHIC>",
      "position" : 3
    },
    {
      "token" : "员",
      "start_offset" : 4,
      "end_offset" : 5,
      "type" : "<IDEOGRAPHIC>",
      "position" : 4
    },
    {
      "token" : "学",
      "start_offset" : 5,
      "end_offset" : 6,
      "type" : "<IDEOGRAPHIC>",
      "position" : 5
    },
    {
      "token" : "习",
      "start_offset" : 6,
      "end_offset" : 7,
      "type" : "<IDEOGRAPHIC>",
      "position" : 6
    },
    {
      "token" : "java",
      "start_offset" : 7,
      "end_offset" : 11,
      "type" : "<ALPHANUM>",
      "position" : 7
    },
    {
      "token" : "太",
      "start_offset" : 11,
      "end_offset" : 12,
      "type" : "<IDEOGRAPHIC>",
      "position" : 8
    },
    {
      "token" : "棒",
      "start_offset" : 12,
      "end_offset" : 13,
      "type" : "<IDEOGRAPHIC>",
      "position" : 9
    },
    {
      "token" : "了",
      "start_offset" : 13,
      "end_offset" : 14,
      "type" : "<IDEOGRAPHIC>",
      "position" : 10
    }
  ]
}
可以看到,标准分词器智能1字1词条,无法正确对中文做分词
再测试IK分词器:
POST /_analyze
{
  "analyzer": "ik_smart",
  "text": "黑马程序员学习java太棒了"
}
执行结果如下:
{
  "tokens" : [
    {
      "token" : "黑马",
      "start_offset" : 0,
      "end_offset" : 2,
      "type" : "CN_WORD",
      "position" : 0
    },
    {
      "token" : "程序员",
      "start_offset" : 2,
      "end_offset" : 5,
      "type" : "CN_WORD",
      "position" : 1
    },
    {
      "token" : "学习",
      "start_offset" : 5,
      "end_offset" : 7,
      "type" : "CN_WORD",
      "position" : 2
    },
    {
      "token" : "java",
      "start_offset" : 7,
      "end_offset" : 11,
      "type" : "ENGLISH",
      "position" : 3
    },
    {
      "token" : "太棒了",
      "start_offset" : 11,
      "end_offset" : 14,
      "type" : "CN_WORD",
      "position" : 4
    }
  ]
}
拓展词典
随着互联网的发展,“造词运动”也越发的频繁。出现了很多新的词语,在原有的词汇列表中并不存在
IK分词器无法对这些词汇分词,测试一下:
POST /_analyze
{
  "analyzer": "ik_max_word",
  "text": "传智播客开设大学,真的泰裤辣!"
}
结果:
{
  "tokens" : [
    {
      "token" : "传",
      "start_offset" : 0,
      "end_offset" : 1,
      "type" : "CN_CHAR",
      "position" : 0
    },
    {
      "token" : "智",
      "start_offset" : 1,
      "end_offset" : 2,
      "type" : "CN_CHAR",
      "position" : 1
    },
    {
      "token" : "播",
      "start_offset" : 2,
      "end_offset" : 3,
      "type" : "CN_CHAR",
      "position" : 2
    },
    {
      "token" : "客",
      "start_offset" : 3,
      "end_offset" : 4,
      "type" : "CN_CHAR",
      "position" : 3
    },
    {
      "token" : "开设",
      "start_offset" : 4,
      "end_offset" : 6,
      "type" : "CN_WORD",
      "position" : 4
    },
    {
      "token" : "大学",
      "start_offset" : 6,
      "end_offset" : 8,
      "type" : "CN_WORD",
      "position" : 5
    },
    {
      "token" : "真的",
      "start_offset" : 9,
      "end_offset" : 11,
      "type" : "CN_WORD",
      "position" : 6
    },
    {
      "token" : "泰",
      "start_offset" : 11,
      "end_offset" : 12,
      "type" : "CN_CHAR",
      "position" : 7
    },
    {
      "token" : "裤",
      "start_offset" : 12,
      "end_offset" : 13,
      "type" : "CN_CHAR",
      "position" : 8
    },
    {
      "token" : "辣",
      "start_offset" : 13,
      "end_offset" : 14,
      "type" : "CN_CHAR",
      "position" : 9
    }
  ]
}
可以看到,传智播客和泰裤辣都无法正确分词
所以要想正确分词,IK分词器的词库也需要不断的更新,IK分词器提供了扩展词汇的功能
1)打开IK分词器config目录:
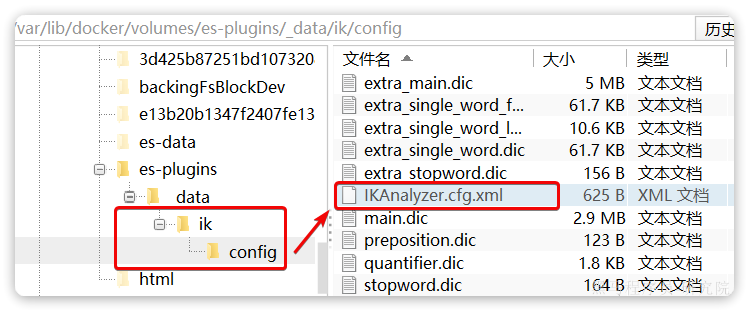
注意,如果采用在线安装的通过,默认是没有config目录的,需要把课前资料提供的ik下的config上传至对应目录
2)在IKAnalyzer.cfg.xml配置文件内容添加:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd">
<properties>
        <comment>IK Analyzer 扩展配置</comment>
        <!--用户可以在这里配置自己的扩展字典 *** 添加扩展词典-->
        <entry key="ext_dict">ext.dic</entry>
</properties>
3)在IK分词器的config目录新建一个 ext.dic,可以参考config目录下复制一个配置文件进行修改
传智播客
泰裤辣
4)重启elasticsearch
docker restart es

# 查看 日志
docker logs -f elasticsearch
再次测试,可以发现传智播客和泰裤辣都正确分词了:
{
  "tokens" : [
    {
      "token" : "传智播客",
      "start_offset" : 0,
      "end_offset" : 4,
      "type" : "CN_WORD",
      "position" : 0
    },
    {
      "token" : "开设",
      "start_offset" : 4,
      "end_offset" : 6,
      "type" : "CN_WORD",
      "position" : 1
    },
    {
      "token" : "大学",
      "start_offset" : 6,
      "end_offset" : 8,
      "type" : "CN_WORD",
      "position" : 2
    },
    {
      "token" : "真的",
      "start_offset" : 9,
      "end_offset" : 11,
      "type" : "CN_WORD",
      "position" : 3
    },
    {
      "token" : "泰裤辣",
      "start_offset" : 11,
      "end_offset" : 14,
      "type" : "CN_WORD",
      "position" : 4
    }
  ]
}
总结
分词器的作用是什么?
- 创建倒排索引时,对文档分词
- 用户搜索时,对输入的内容分词
IK分词器有几种模式?
ik_smart:智能切分,粗粒度ik_max_word:最细切分,细粒度
IK分词器如何拓展词条?如何停用词条?
- 利用config目录的
IkAnalyzer.cfg.xml文件添加拓展词典和停用词典 - 在词典中添加拓展词条或者停用词条
基础概念
文档和字段
elasticsearch是面向文档(Document)存储的,可以是数据库中的一条商品数据,一个订单信息。文档数据会被序列化为json格式后存储在elasticsearch中:
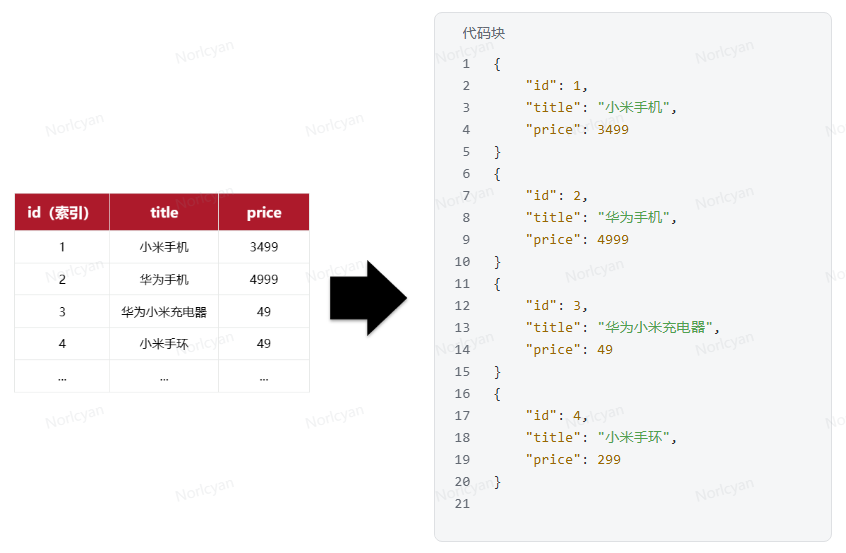
因此,原本数据库中的一行数据就是ES中的一个JSON文档;而数据库中每行数据都包含很多列,这些列就转换为JSON文档中的字段(Field)
索引和映射
随着业务发展,需要在es中存储的文档也会越来越多,比如有商品的文档、用户的文档、订单文档等等:
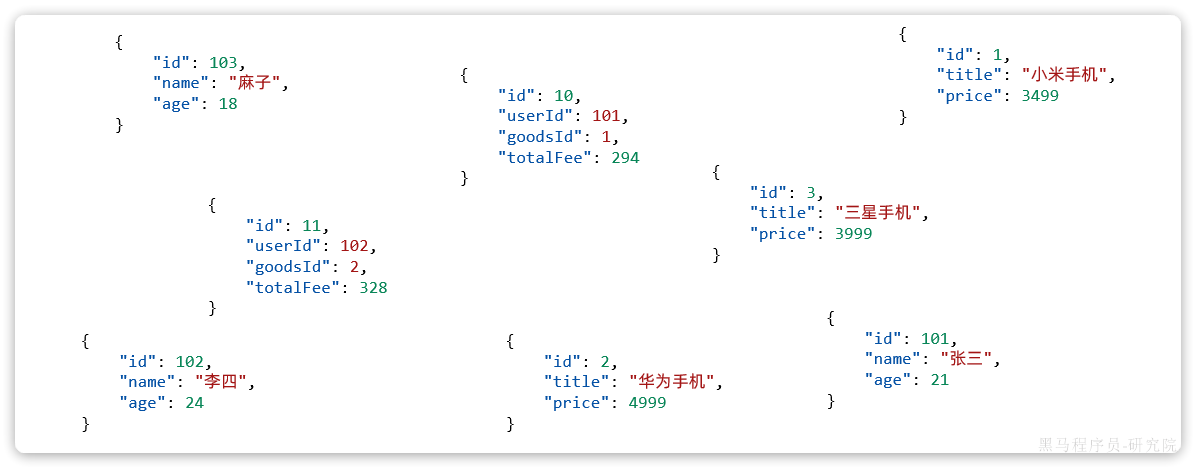
所有文档都散乱存放显然非常混乱,也不方便管理。
因此,将类型相同的文档集中在一起管理,称为索引(Index)。例如:
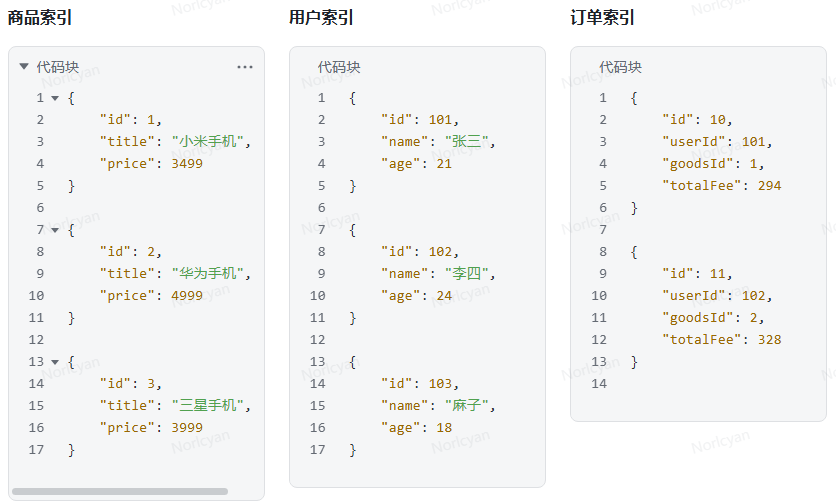
- 所有用户文档,就可以组织在一起,称为用户的索引;
- 所有商品的文档,可以组织在一起,称为商品的索引;
- 所有订单的文档,可以组织在一起,称为订单的索引;
因此,可以把索引当做是数据库中的表
数据库的表会有约束信息,用来定义表的结构、字段的名称、类型等信息。因此,索引库中就有映射(mapping),是索引中文档的字段约束信息,类似表的结构约束
mysql与elasticsearch
把mysql与elasticsearch的概念做一下对比:
| MySQL | Elasticsearch | 说明 |
|---|---|---|
| Table | Index | 索引(index),就是文档的集合,类似数据库的表(table) |
| Row | Document | 文档(Document),就是一条条的数据,类似数据库中的行(Row),文档都是JSON格式 |
| Column | Field | 字段(Field),就是JSON文档中的字段,类似数据库中的列(Column) |
| Schema | Mapping | Mapping(映射)是索引中文档的约束,例如字段类型约束。类似数据库的表结构(Schema) |
| SQL | DSL | DSL是elasticsearch提供的JSON风格的请求语句,用来操作elasticsearch,实现CRUD |
如图:
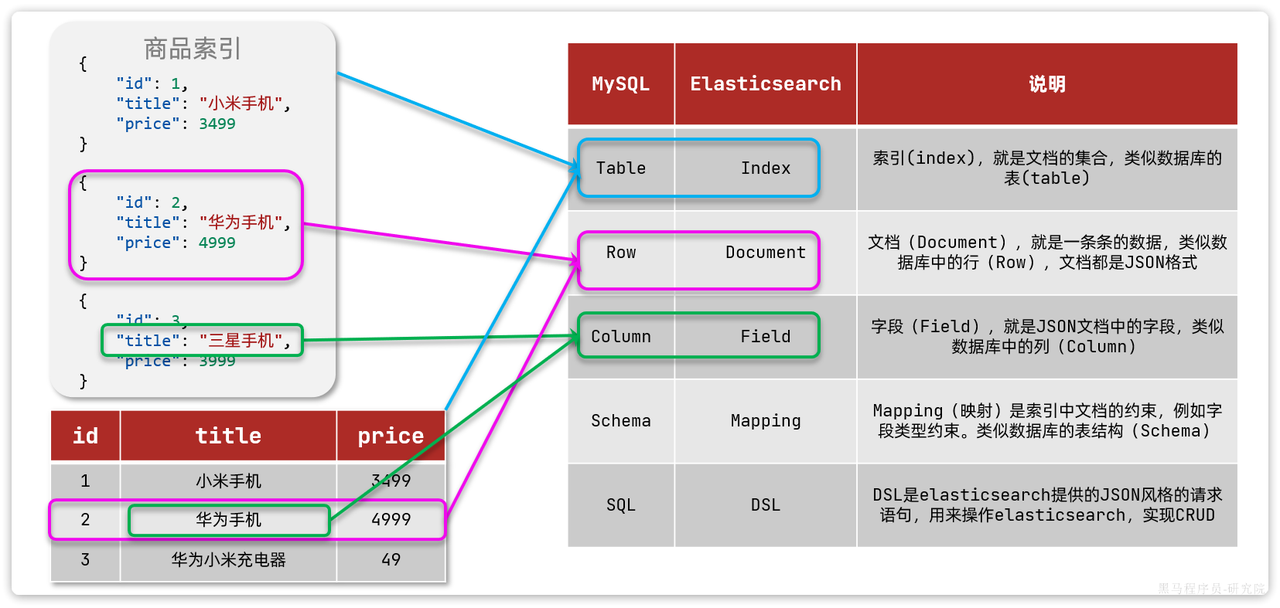
两者各自的擅长之处:
- Mysql:擅长事务类型操作,可以确保数据的安全和一致性
- Elasticsearch:擅长海量数据的搜索、分析、计算
因此在企业中,往往是两者结合使用:
- 对安全性要求较高的写操作,使用mysql实现
- 对查询性能要求较高的搜索需求,使用elasticsearch实现
- 两者再基于某种方式,实现数据的同步,保证一致性
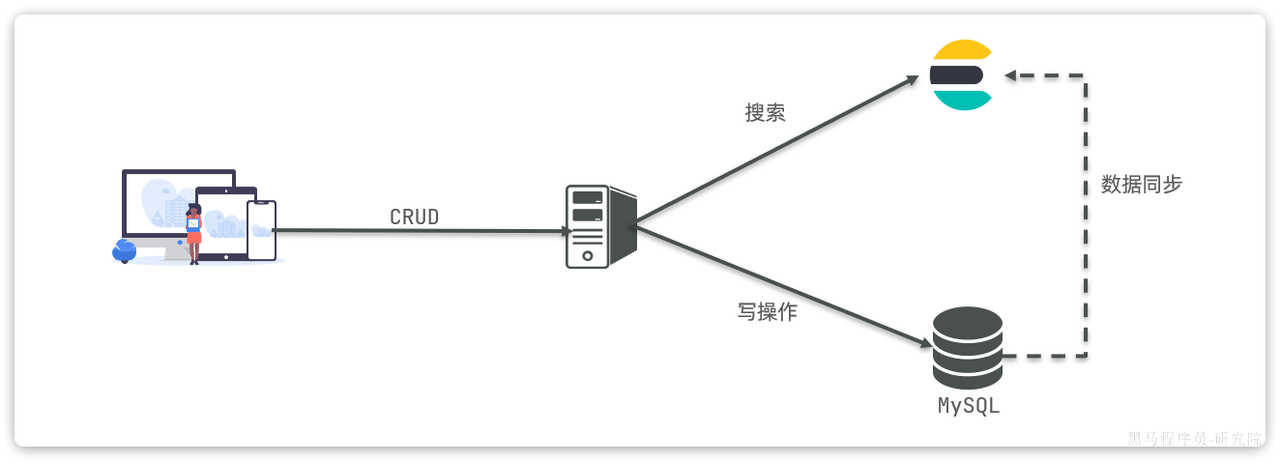
ES基础操作
索引库操作
Index就类似数据库表,Mapping映射就类似表的结构。要向es中存储数据,必须先创建Index和Mapping
Mapping映射属性
Mapping是对索引库中文档的约束,常见的Mapping属性包括:
type:字段数据类型,常见的简单类型有:- 字符串:
text(可分词的文本)、keyword(精确值,例如:品牌、国家、ip地址) - 数值:
long、integer、short、byte、double、float、 - 布尔:
boolean - 日期:
date - 对象:
object index:是否创建索引,默认为trueanalyzer:使用哪种分词器properties:该字段的子字段
例如下面的json文档:
{
    "age": 21,
    "weight": 52.1,
    "isMarried": false,
    "info": "黑马程序员Java讲师",
    "email": "zy@itcast.cn",
    "score": [99.1, 99.5, 98.9],
    "name": {
        "firstName": "云",
        "lastName": "赵"
    }
}
对应的每个字段映射(Mapping):
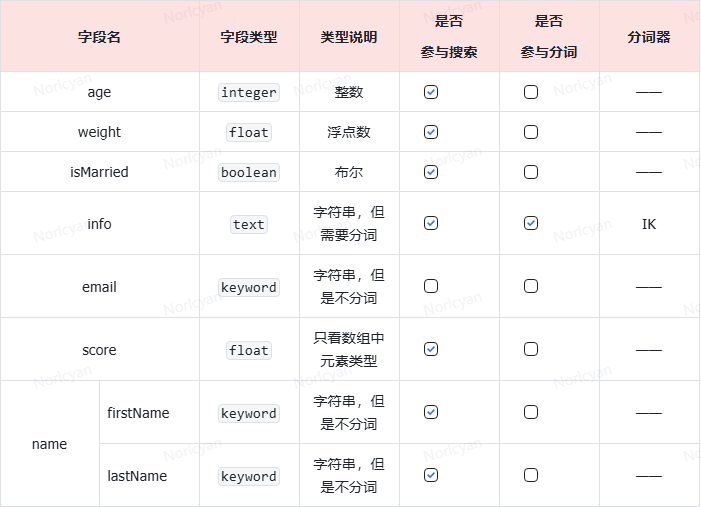
索引库的CRUD
由于Elasticsearch采用的是Restful风格的API,因此其请求方式和路径相对都比较规范,而且请求参数也都采用JSON风格
创建索引库和映射
基本语法:
- 请求方式:
PUT - 请求路径:
/索引库名,可以自定义 - 请求参数:
mapping映射
PUT /索引库名称
{
  "mappings": {
    "properties": {
      "字段1":{
        "type": "text",
        "analyzer": "ik_smart"
      },
      "字段2":{
        "type": "keyword",
        "index": "false"
      },
      "字段3":{
        "properties": {
          "子属性1": {
            "type": "keyword"
          }
        }
      },
      // ...略
    }
  }
}
示例:
# PUT /heima
{
  "mappings": {
    "properties": {
      "info":{
        "type": "text",
        "analyzer": "ik_smart"
      },
      "email":{
        "type": "keyword",
        "index": "false"
      },
      "name":{
        "properties": {
          "firstName": {
            "type": "keyword"
          }
        }
      }
    }
  }
}
查询索引库
基本语法:
- 请求方式:GET
- 请求路径:/索引库名
- 请求参数:无
格式:
GET /索引库名
示例:
GET /heima
修改索引库
倒排索引结构虽然不复杂,但是一旦数据结构改变(比如改变了分词器),就需要重新创建倒排索引,这简直是灾难。因此索引库**一旦创建,无法修改mapping**
虽然无法修改mapping中已有的字段,但是却允许添加新的字段到mapping中,因为不会对倒排索引产生影响。因此修改索引库能做的就是向索引库中添加新字段,或者更新索引库的基础属性
语法说明:
PUT /索引库名/_mapping
{
  "properties": {
    "新字段名":{
      "type": "integer"
    }
  }
}
示例:
PUT /heima/_mapping
{
  "properties": {
    "age":{
      "type": "integer"
    }
  }
}
删除索引库
语法:
- 请求方式:DELETE
- 请求路径:/索引库名
- 请求参数:无
格式:
DELETE /索引库名
示例:
DELETE /heima
总结
索引库操作有哪些?
- 创建索引库:PUT /索引库名
- 查询索引库:GET /索引库名
- 删除索引库:DELETE /索引库名
- 修改索引库,添加字段:PUT /索引库名/_mapping
可以看到,对索引库的操作基本遵循的Restful的风格,因此API接口非常统一,方便记忆
文档操作
新增文档
语法:
POST /索引库名/_doc/文档id
{
    "字段1": "值1",
    "字段2": "值2",
    "字段3": {
        "子属性1": "值3",
        "子属性2": "值4"
    },
}
示例:
POST /heima/_doc/1
{
    "info": "黑马程序员Java讲师",
    "email": "zy@itcast.cn",
    "name": {
        "firstName": "云",
        "lastName": "赵"
    }
}
响应:
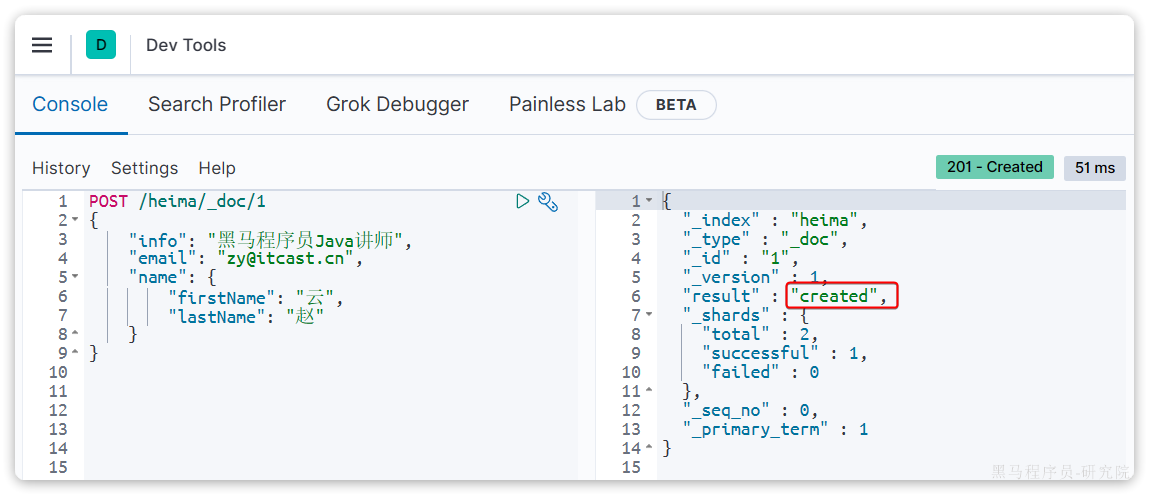
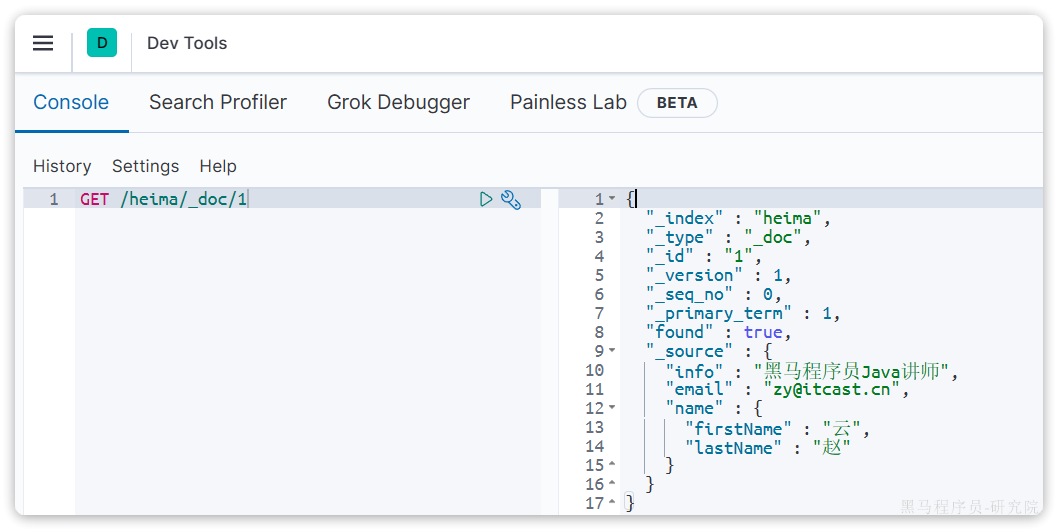
查询文档
语法:
GET /{索引库名称}/_doc/{id}
示例:
GET /heima/_doc/1
查看结果:
删除文档
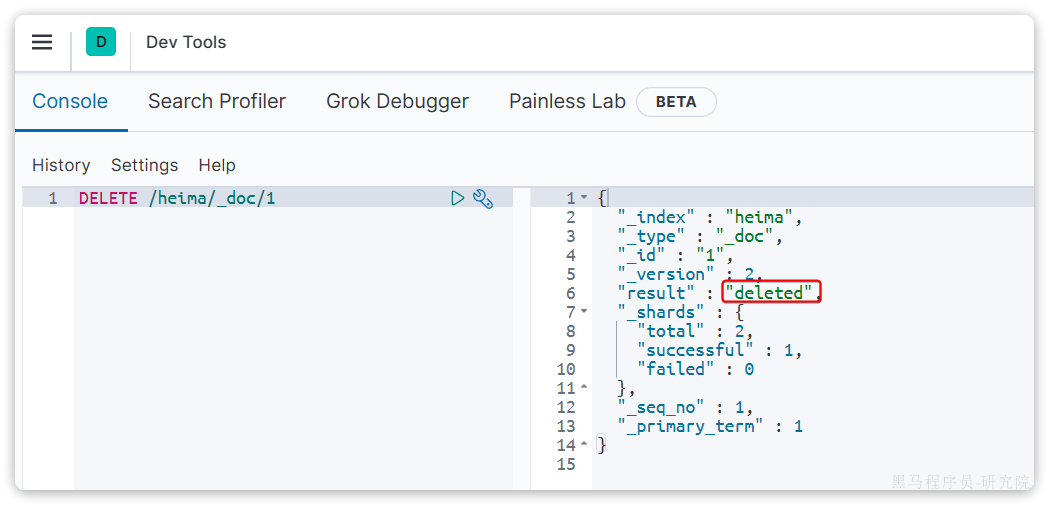
删除使用DELETE请求,同样,需要根据id进行删除:
语法:
DELETE /{索引库名}/_doc/id值
示例:
DELETE /heima/_doc/1
结果:
修改文档
修改有两种方式:
- 全量修改:直接覆盖原来的文档
- 局部修改:修改文档中的部分字段
全量修改
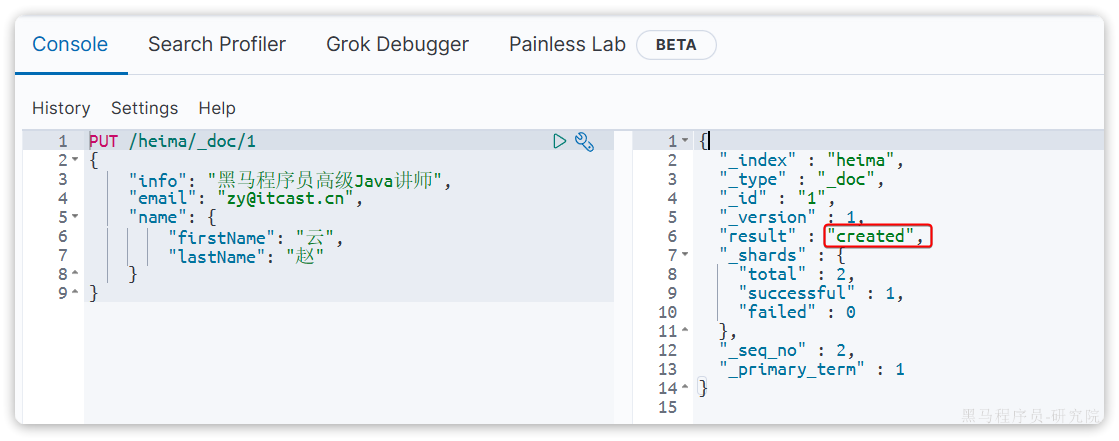
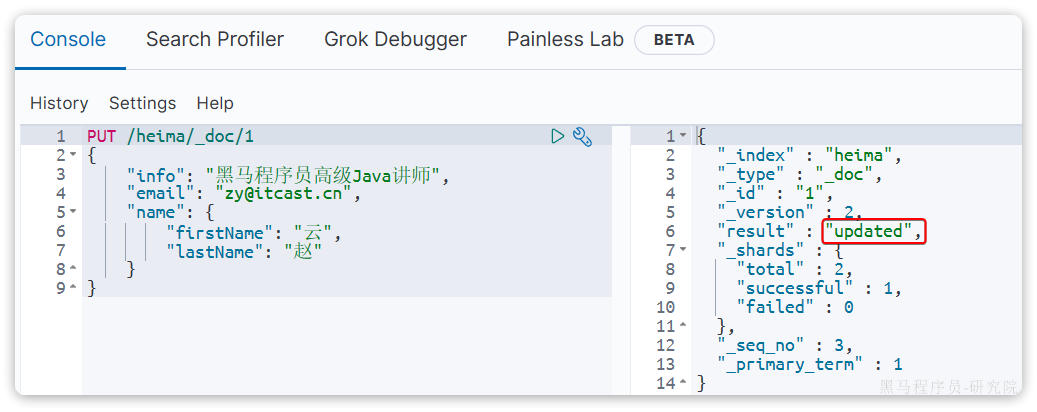
全量修改是覆盖原来的文档,其本质是两步操作:
- 根据指定的id删除文档
- 新增一个相同id的文档
注意:如果根据id删除时,id不存在,第二步的新增也会执行,也就从修改变成了新增操作了
语法:
PUT /{索引库名}/_doc/文档id
{
    "字段1": "值1",
    "字段2": "值2",
    // ... 略
}
示例:
PUT /heima/_doc/1
{
    "info": "黑马程序员高级Java讲师",
    "email": "zy@itcast.cn",
    "name": {
        "firstName": "云",
        "lastName": "赵"
    }
}
由于id为1的文档已经被删除,所以第一次执行时,得到的反馈是created:
所以如果执行第2次时,得到的反馈则是updated:
局部修改
语法:
POST /{索引库名}/_update/文档id
{
    "doc": {
         "字段名": "新的值",
    }
}
示例:
POST /heima/_update/1
{
  "doc": {
    "email": "ZhaoYun@itcast.cn"
  }
}
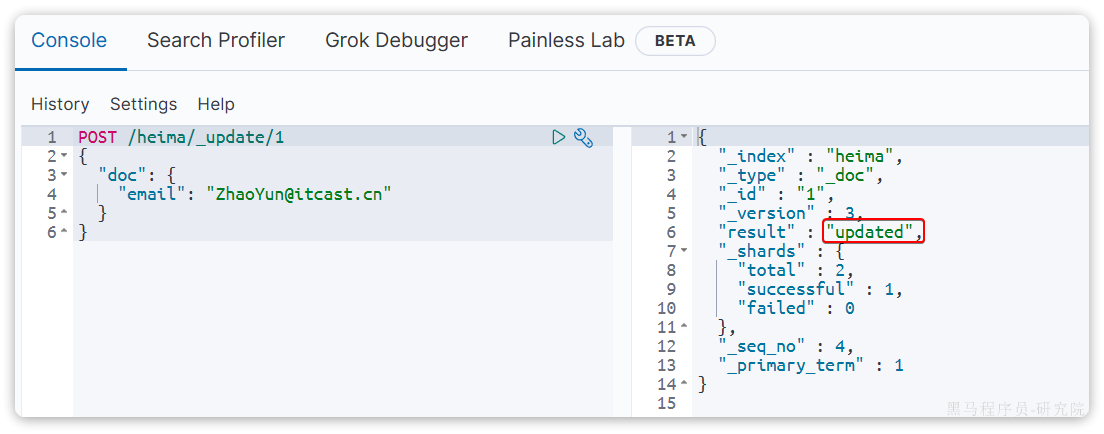
执行结果:
批处理
批处理采用POST请求,基本语法如下:
POST _bulk
{ "index" : { "_index" : "test", "_id" : "1" } }
{ "field1" : "value1" }
{ "delete" : { "_index" : "test", "_id" : "2" } }
{ "create" : { "_index" : "test", "_id" : "3" } }
{ "field1" : "value3" }
{ "update" : {"_id" : "1", "_index" : "test"} }
{ "doc" : {"field2" : "value2"} }
其中:
index代表新增操作_index:指定索引库名_id指定要操作的文档id{ "field1" : "value1" }:则是要新增的文档内容delete代表删除操作_index:指定索引库名_id指定要操作的文档idupdate代表更新操作_index:指定索引库名_id指定要操作的文档id{ "doc" : {"field2" : "value2"} }:要更新的文档字段
示例,批量新增:
POST /_bulk
{"index": {"_index":"heima", "_id": "3"}}
{"info": "黑马程序员C++讲师", "email": "ww@itcast.cn", "name":{"firstName": "五", "lastName":"王"}}
{"index": {"_index":"heima", "_id": "4"}}
{"info": "黑马程序员前端讲师", "email": "zhangsan@itcast.cn", "name":{"firstName": "三", "lastName":"张"}}
一次操作对应一条数据,不能在一次操作中写多条数据
RestAPI
ES官方提供了各种不同语言的客户端,用来操作ES。这些客户端的本质就是组装DSL语句,通过http请求发送给ES
官方文档地址:https://www.elastic.co/guide/en/elasticsearch/client/index.html
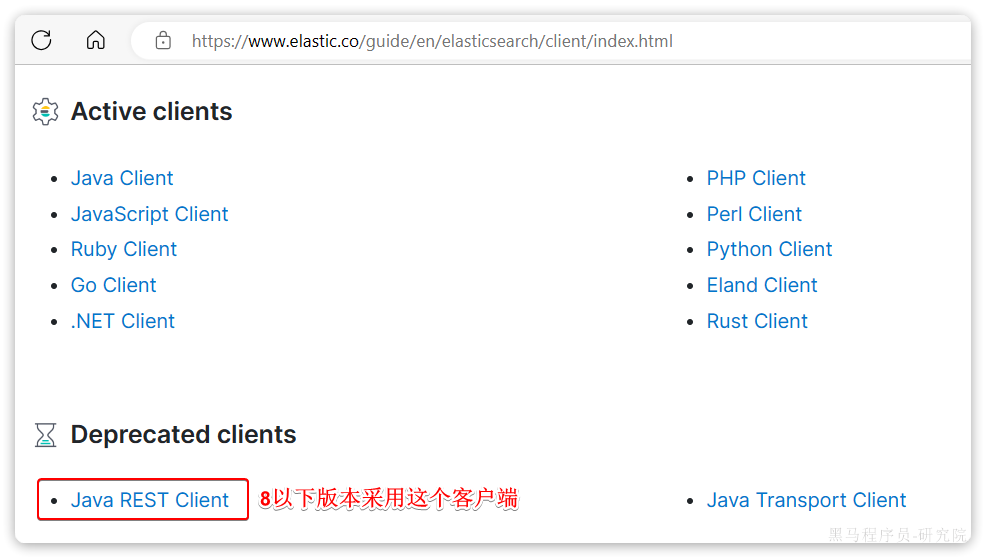
由于ES目前最新版本是8.8,提供了全新版本的客户端,老版本的客户端已经被标记为过时。而当前用的是7.12版本,因此只能使用老版本客户端:
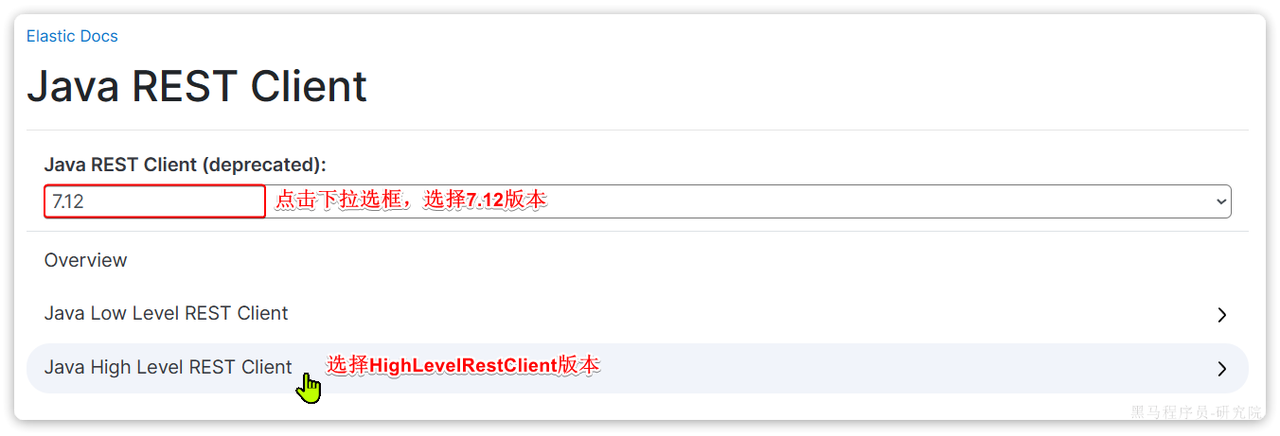
然后选择7.12版本,HighLevelRestClient版本:
初始化RestClient
在elasticsearch提供的API中,与elasticsearch一切交互都封装在一个名为RestHighLevelClient的类中,必须先完成这个对象的初始化,建立与elasticsearch的连接
分为三步:
- 在
item-service模块中引入es的RestHighLevelClient依赖:
<dependency>
    <groupId>org.elasticsearch.client</groupId>
    <artifactId>elasticsearch-rest-high-level-client</artifactId>
</dependency>
- 因为SpringBoot默认的ES版本是
7.17.10,所以需要覆盖默认的ES版本:
<properties>
    <maven.compiler.source>11</maven.compiler.source>
    <maven.compiler.target>11</maven.compiler.target>
    <elasticsearch.version>7.12.1</elasticsearch.version>
</properties>
- 初始化RestHighLevelClient:
RestHighLevelClient client = new RestHighLevelClient(RestClient.builder(
        HttpHost.create("http://192.168.0.104:9200")
));
这里为了单元测试方便,创建一个测试类IndexTest,然后将初始化的代码编写在@BeforeEach方法中:
package com.hmall.item.es;

import org.apache.http.HttpHost;
import org.elasticsearch.client.RestClient;
import org.elasticsearch.client.RestHighLevelClient;
import org.junit.jupiter.api.AfterEach;
import org.junit.jupiter.api.BeforeEach;
import org.junit.jupiter.api.Test;

import java.io.IOException;

public class IndexTest {

    private RestHighLevelClient client;

    @BeforeEach
    void setUp() {
        this.client = new RestHighLevelClient(RestClient.builder(
                HttpHost.create("http://192.168.150.101:9200")
        ));
    }

    @Test
    void testConnect() {
        System.out.println(client);
    }

    @AfterEach
    void tearDown() throws IOException {
        this.client.close();
    }
}
创建索引库
由于要实现对商品搜索,所以需要将商品添加到Elasticsearch中,不过需要根据搜索业务的需求来设定索引库结构,而不是一股脑的把MySQL数据写入Elasticsearch
Mapping映射
搜索页面的效果如图所示:
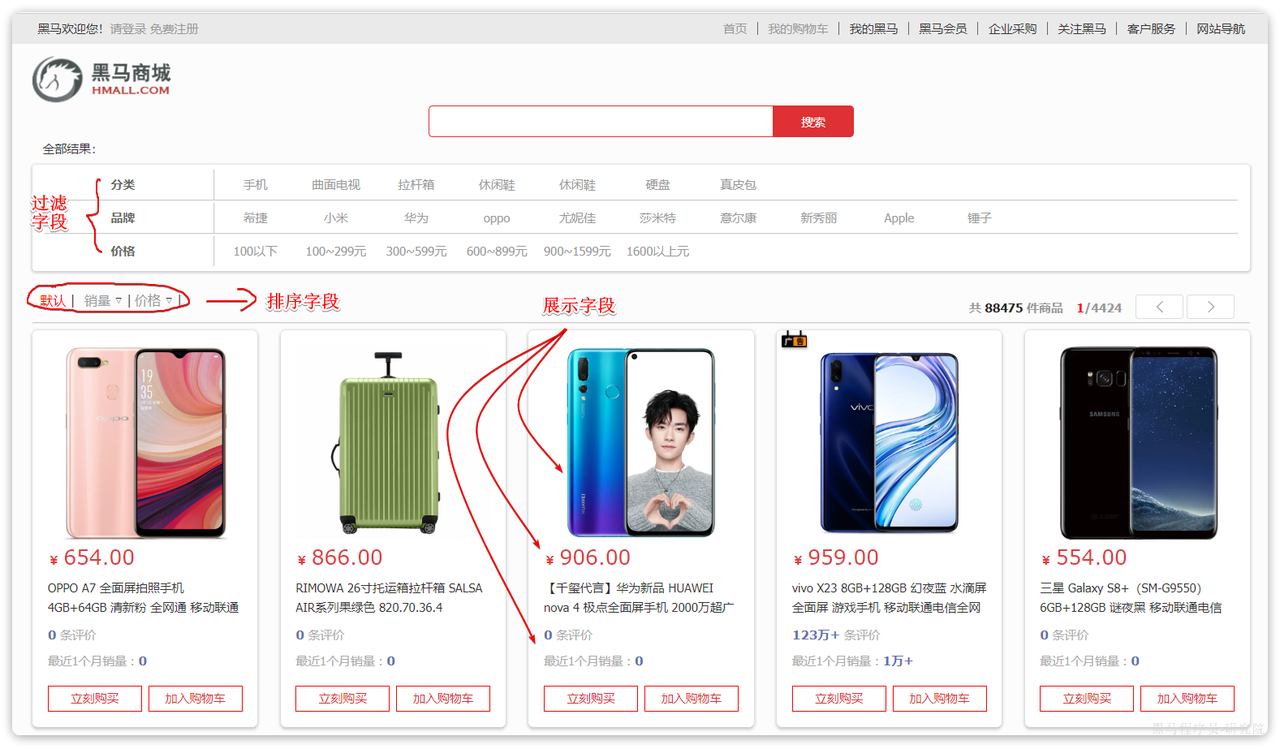
实现搜索功能需要的字段包括三大部分:
- 搜索过滤字段
- 分类
- 品牌
- 价格
- 排序字段
- 默认:按照更新时间降序排序
- 销量
- 价格
- 展示字段
- 商品id:用于点击后跳转
- 图片地址
- 是否是广告推广商品
- 名称
- 价格
- 评价数量
- 销量
对应的商品表结构如下,索引库无关字段已经划掉:
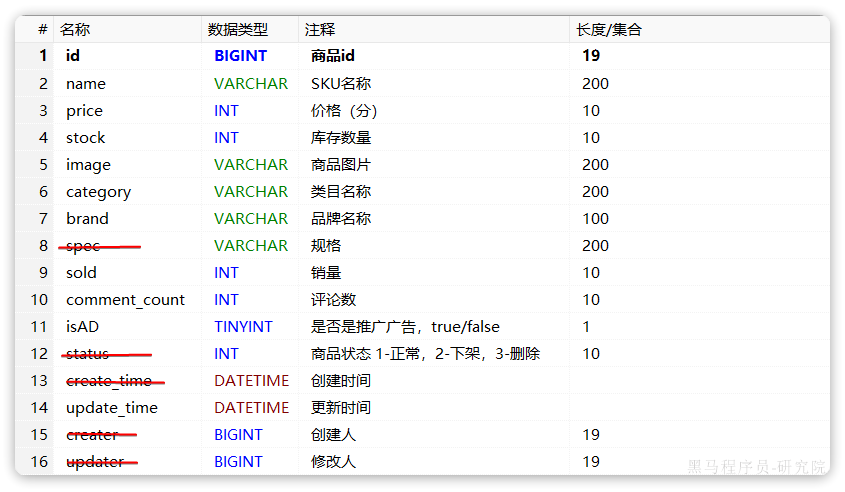
结合数据库表结构,以上字段对应的mapping映射属性如下:
| 字段名 | 字段类型 | 类型说明 | 是否****参与搜索 | 是否****参与分词 | 分词器 |
|---|---|---|---|---|---|
| id | long |
长整数 | ✔ | —— | |
| name | text |
字符串,参与分词搜索 | ✔ | ✔ | IK |
| price | integer |
以分为单位,所以是整数 | ✔ | —— | |
| stock | integer |
字符串,但需要分词 | ✔ | —— | |
| image | keyword |
字符串,但是不分词 | —— | ||
| category | keyword |
字符串,但是不分词 | ✔ | —— | |
| brand | keyword |
字符串,但是不分词 | ✔ | —— | |
| sold | integer |
销量,整数 | ✔ | —— | |
| commentCount | integer |
评价,整数 | —— | ||
| isAD | boolean |
布尔类型 | ✔ | —— | |
| updateTime | Date |
更新时间 | ✔ | —— |
因此,最终索引库文档结构应该是这样:
PUT /items
{
  "mappings": {
    "properties": {
      "id": {
        "type": "keyword"
      },
      "name":{
        "type": "text",
        "analyzer": "ik_max_word"
      },
      "price":{
        "type": "integer"
      },
      "stock":{
        "type": "integer"
      },
      "image":{
        "type": "keyword",
        "index": false
      },
      "category":{
        "type": "keyword"
      },
      "brand":{
        "type": "keyword"
      },
      "sold":{
        "type": "integer"
      },
      "commentCount":{
        "type": "integer",
        "index": false
      },
      "isAD":{
        "type": "boolean"
      },
      "updateTime":{
        "type": "date"
      }
    }
  }
}
创建索引
创建索引库的API如下:
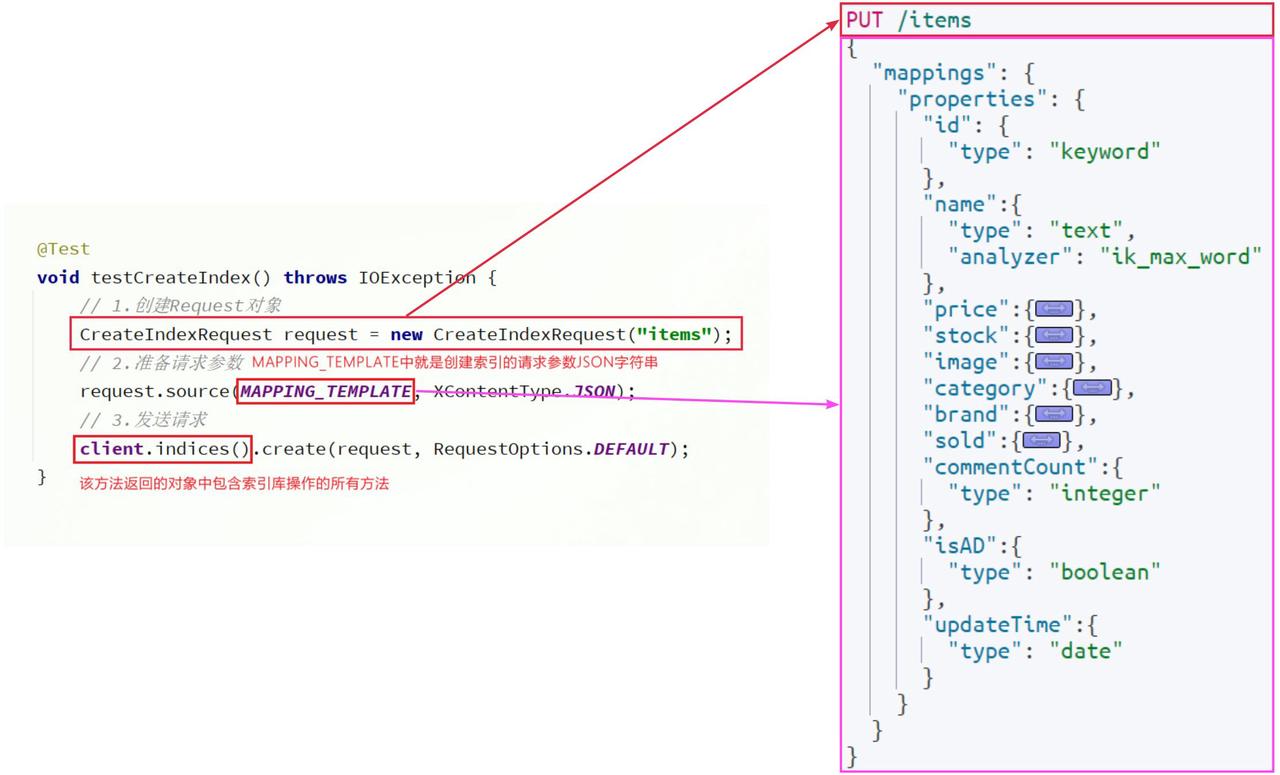
代码分为三步:
- 1)创建Request对象。
- 因为是创建索引库的操作,因此Request是
CreateIndexRequest - 2)添加请求参数
- 其实就是Json格式的Mapping映射参数。因为json字符串很长,这里是定义了静态字符串常量
MAPPING_TEMPLATE,让代码看起来更加优雅 - 3)发送请求
client.indices()方法的返回值是IndicesClient类型,封装了所有与索引库操作有关的方法。例如创建索引、删除索引、判断索引是否存在等
删除索引库
删除索引库的请求非常简单:
DELETE /hotel
与创建索引库相比:
- 请求方式从PUT变为DELTE
- 请求路径不变
- 无请求参数
所以代码的差异,注意体现在Request对象上。流程如下:
- 1)创建Request对象。这次是DeleteIndexRequest对象
- 2)准备参数。这里是无参,因此省略
- 3)发送请求。改用delete方法
在item-service中的IndexTest测试类中,编写单元测试,实现删除索引:
@Test
void testDeleteIndex() throws IOException {
    // 1.创建Request对象
    DeleteIndexRequest request = new DeleteIndexRequest("items");
    // 2.发送请求
    client.indices().delete(request, RequestOptions.DEFAULT);
}
判断索引库是否存在
判断索引库是否存在,本质就是查询,对应的请求语句是:
GET /hotel
因此与删除的Java代码流程是类似的,流程如下:
- 1)创建Request对象。这次是GetIndexRequest对象
- 2)准备参数。这里是无参,直接省略
- 3)发送请求。改用exists方法
@Test
void testExistsIndex() throws IOException {
    // 1.创建Request对象
    GetIndexRequest request = new GetIndexRequest("items");
    // 2.发送请求
    boolean exists = client.indices().exists(request, RequestOptions.DEFAULT);
    // 3.输出
    System.err.println(exists ? "索引库已经存在!" : "索引库不存在!");
}
总结
JavaRestClient操作elasticsearch的流程基本类似。核心是client.indices()方法来获取索引库的操作对象。
索引库操作的基本步骤:
- 初始化
RestHighLevelClient - 创建XxxIndexRequest。XXX是
Create、Get、Delete - 准备请求参数(
Create时需要,其它是无参,可以省略) - 发送请求。调用
RestHighLevelClient#indices().xxx()方法,xxx是create、exists、delete
RestClient操作文档
索引库准备好以后,就可以操作文档了。为了与索引库操作分离,我们再次创建一个测试类,做两件事情:
- 初始化RestHighLevelClient
- 商品数据在数据库,需要利用IItemService去查询,所以注入这个接口
package com.hmall.item.es;

import com.hmall.item.service.IItemService;
import org.apache.http.HttpHost;
import org.elasticsearch.client.RestClient;
import org.elasticsearch.client.RestHighLevelClient;
import org.junit.jupiter.api.AfterEach;
import org.junit.jupiter.api.BeforeEach;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

import java.io.IOException;

@SpringBootTest(properties = "spring.profiles.active=local")
public class DocumentTest {

    private RestHighLevelClient client;
    @Autowired
    private IItemService itemService;

    @BeforeEach
    void setUp() {
        this.client = new RestHighLevelClient(RestClient.builder(
                HttpHost.create("http://192.168.150.101:9200")
        ));
    }

    @AfterEach
    void tearDown() throws IOException {
        this.client.close();
    }
}
新增文档
需要将数据库中的商品信息导入elasticsearch中,而不是造假数据了
实体类
索引库结构与数据库结构还存在一些差异,因此要定义一个索引库结构对应的实体。
在hm-service模块的com.hmall.item.domain.dto包中定义一个新的DTO:
package com.hmall.item.domain.po;

import io.swagger.annotations.ApiModel;
import io.swagger.annotations.ApiModelProperty;
import lombok.Data;

import java.time.LocalDateTime;

@Data
@ApiModel(description = "索引库实体")
public class ItemDoc{

    @ApiModelProperty("商品id")
    private String id;

    @ApiModelProperty("商品名称")
    private String name;

    @ApiModelProperty("价格(分)")
    private Integer price;

    @ApiModelProperty("商品图片")
    private String image;

    @ApiModelProperty("类目名称")
    private String category;

    @ApiModelProperty("品牌名称")
    private String brand;

    @ApiModelProperty("销量")
    private Integer sold;

    @ApiModelProperty("评论数")
    private Integer commentCount;

    @ApiModelProperty("是否是推广广告,true/false")
    private Boolean isAD;

    @ApiModelProperty("更新时间")
    private LocalDateTime updateTime;
}
API语法
新增文档的请求语法如下:
POST /{索引库名}/_doc/1
{
    "name": "Jack",
    "age": 21
}
对应的JavaAPI如下:
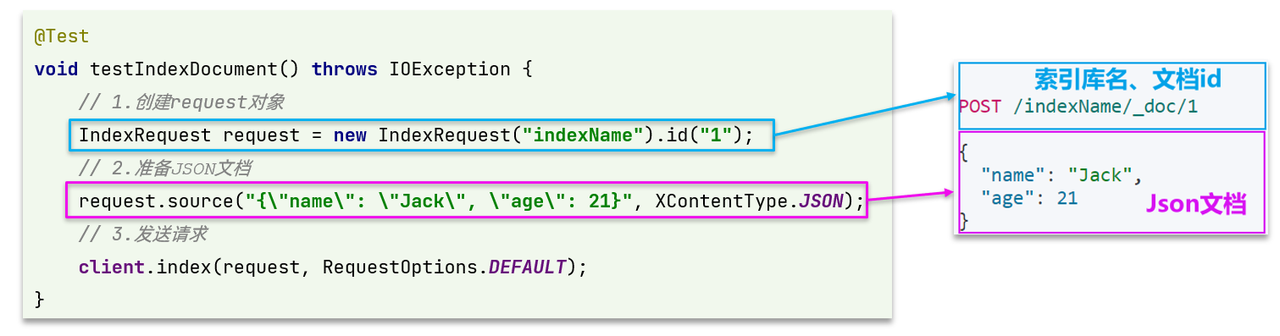
可以看到与索引库操作的API非常类似,同样是三步走:
- 1)创建Request对象,这里是
IndexRequest,因为添加文档就是创建倒排索引的过程 - 2)准备请求参数,本例中就是Json文档
- 3)发送请求
变化的地方在于,这里直接使用client.xxx()的API,不再需要client.indices()了
完整代码
代码整体步骤如下:
- 1)根据id查询商品数据
Item - 2)将
Item封装为ItemDoc - 3)将
ItemDoc序列化为JSON - 4)创建IndexRequest,指定索引库名和id
- 5)准备请求参数,也就是JSON文档
- 6)发送请求
在item-service的DocumentTest测试类中,编写单元测试:
@Test
void testAddDocument() throws IOException {
    // 1.根据id查询商品数据
    Item item = itemService.getById(100002644680L);
    // 2.转换为文档类型
    ItemDoc itemDoc = BeanUtil.copyProperties(item, ItemDoc.class);
    // 3.将ItemDTO转json
    String doc = JSONUtil.toJsonStr(itemDoc);

    // 1.准备Request对象
    IndexRequest request = new IndexRequest("items").id(itemDoc.getId());
    // 2.准备Json文档
    request.source(doc, XContentType.JSON);
    // 3.发送请求
    client.index(request, RequestOptions.DEFAULT);
}
查询文档
语法说明
查询的请求语句如下:
GET /{索引库名}/_doc/{id}
与之前的流程类似,代码大概分2步:
- 创建Request对象
- 准备请求参数,这里是无参,直接省略
- 发送请求
不过查询的目的是得到结果,解析为ItemDTO,还要再加一步对结果的解析。示例代码如下:
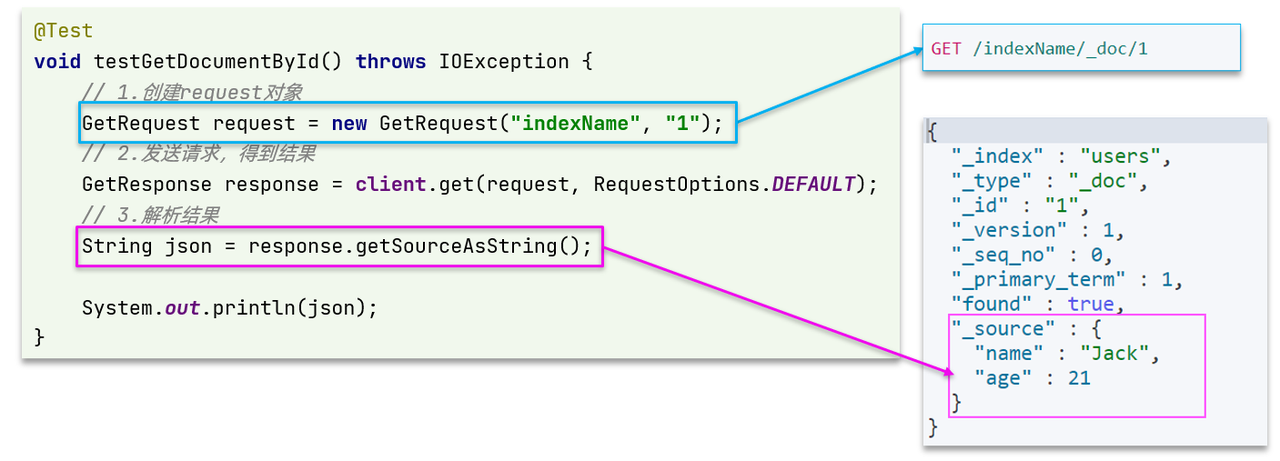
可以看到,响应结果是一个JSON,其中文档放在一个_source属性中,因此解析就是拿到_source,反序列化为Java对象即可
其它代码与之前类似,流程如下:
- 1)准备Request对象。这次是查询,所以是
GetRequest - 2)发送请求,得到结果。因为是查询,这里调用
client.get()方法 - 3)解析结果,就是对JSON做反序列化
完整代码
在item-service的DocumentTest测试类中,编写单元测试:
@Test
void testGetDocumentById() throws IOException {
    // 1.准备Request对象
    GetRequest request = new GetRequest("items").id("100002644680");
    // 2.发送请求
    GetResponse response = client.get(request, RequestOptions.DEFAULT);
    // 3.获取响应结果中的source
    String json = response.getSourceAsString();

    ItemDoc itemDoc = JSONUtil.toBean(json, ItemDoc.class);
    System.out.println("itemDoc= " + ItemDoc);
}
删除文档
删除的请求语句如下:
DELETE /hotel/_doc/{id}
与查询相比,仅仅是请求方式从DELETE变成GET,可以想象Java代码应该依然是2步走:
- 1)准备Request对象,因为是删除,这次是
DeleteRequest对象。要指定索引库名和id - 2)准备参数,无参,直接省略
- 3)发送请求。因为是删除,所以是
client.delete()方法
在item-service的DocumentTest测试类中,编写单元测试:
@Test
void testDeleteDocument() throws IOException {
    // 1.准备Request,两个参数,第一个是索引库名,第二个是文档id
    DeleteRequest request = new DeleteRequest("item", "100002644680");
    // 2.发送请求
    client.delete(request, RequestOptions.DEFAULT);
}
修改文档
两种方式:
- 全量修改:本质是先根据id删除,再新增
- 局部修改:修改文档中的指定字段值
在RestClient的API中,全量修改与新增的API完全一致,判断依据是ID:
- 如果新增时,ID已经存在,则修改
- 如果新增时,ID不存在,则新增
主要关注局部修改的API即可
语法说明
局部修改的请求语法如下:
POST /{索引库名}/_update/{id}
{
  "doc": {
    "字段名": "字段值",
    "字段名": "字段值"
  }
}
代码示例如图:
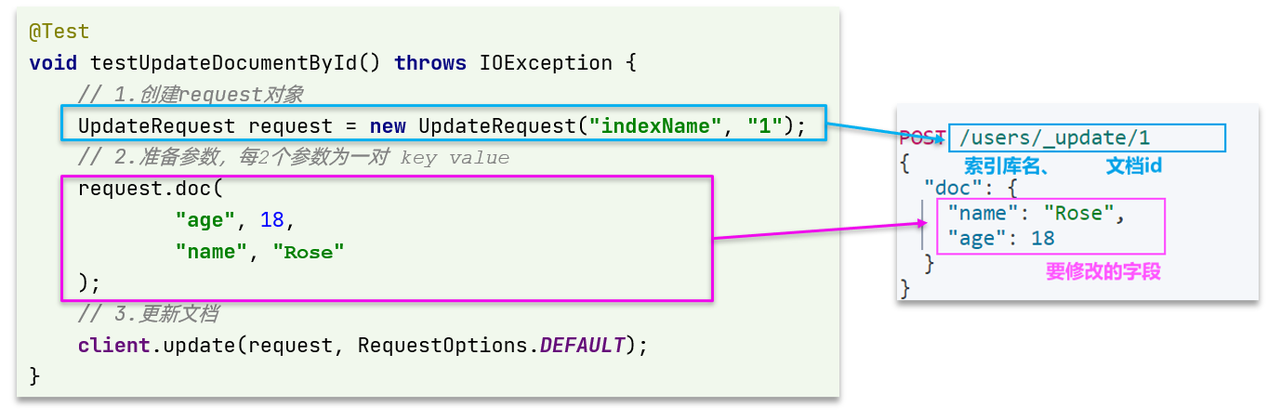
与之前类似,也是三步走:
- 1)准备
Request对象。这次是修改,所以是UpdateRequest - 2)准备参数。也就是JSON文档,里面包含要修改的字段
- 3)更新文档。这里调用
client.update()方法
完整代码
在item-service的DocumentTest测试类中,编写单元测试:
@Test
void testUpdateDocument() throws IOException {
    // 1.准备Request
    UpdateRequest request = new UpdateRequest("items", "100002644680");
    // 2.准备请求参数
    request.doc(
            "price", 58800,
            "commentCount", 1
    );
    // 3.发送请求
    client.update(request, RequestOptions.DEFAULT);
}
批量导入文档
在之前的案例中,都是操作单个文档。而数据库中的商品数据实际会达到数十万条,某些项目中可能达到数百万条。
如果要将这些数据导入索引库,肯定不能逐条导入,而是采用批处理方案。常见的方案有:
- 利用Logstash批量导入
- 需要安装Logstash
- 对数据的再加工能力较弱
- 无需编码,但要学习编写Logstash导入配置
- 利用JavaAPI批量导入
- 需要编码,但基于JavaAPI,学习成本低
- 更加灵活,可以任意对数据做再加工处理后写入索引库
所以更推荐采用JavaAPI的方式进行批量导入
语法说明
批处理与前面讲的文档的CRUD步骤基本一致:
- 创建Request,但这次用的是
BulkRequest - 准备请求参数
- 发送请求,这次要用到
client.bulk()方法
BulkRequest本身其实并没有请求参数,其本质就是将多个普通的CRUD请求组合在一起发送。例如:
- 批量新增文档,就是给每个文档创建一个
IndexRequest请求,然后封装到BulkRequest中,一起发出 - 批量删除,就是创建N个
DeleteRequest请求,然后封装到BulkRequest,一起发出
因此BulkRequest中提供了add方法,用以添加其它CRUD的请求:
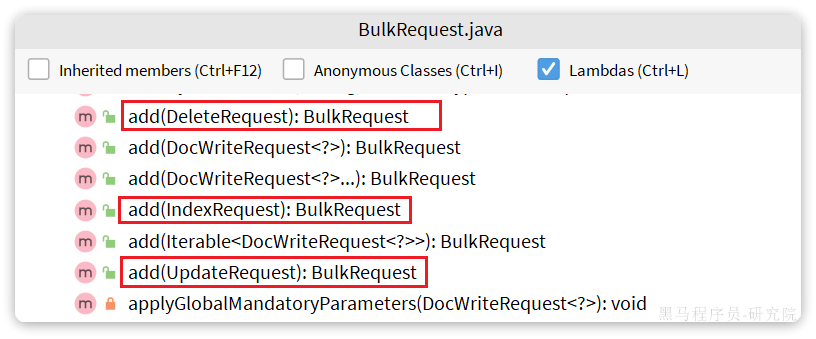
可以看到,能添加的请求有:
IndexRequest,也就是新增UpdateRequest,也就是修改DeleteRequest,也就是删除
因此Bulk中添加了多个IndexRequest,就是批量新增功能了。示例:
@Test
void testBulk() throws IOException {
    // 1.创建Request
    BulkRequest request = new BulkRequest();
    // 2.准备请求参数
    request.add(new IndexRequest("items").id("1").source("json doc1", XContentType.JSON));
    request.add(new IndexRequest("items").id("2").source("json doc2", XContentType.JSON));
    // 3.发送请求
    client.bulk(request, RequestOptions.DEFAULT);
}
完整代码
item-service的DocumentTest测试类中,编写单元测试:
@Test
void testLoadItemDocs() throws IOException {
    // 分页查询商品数据
    int pageNo = 1;
    int size = 1000;
    while (true) {
        Page<Item> page = itemService.lambdaQuery().eq(Item::getStatus, 1).page(new Page<Item>(pageNo, size));
        // 非空校验
        List<Item> items = page.getRecords();
        if (CollUtils.isEmpty(items)) {
            return;
        }
        log.info("加载第{}页数据,共{}条", pageNo, items.size());
        // 1.创建Request
        BulkRequest request = new BulkRequest("items");
        // 2.准备参数,添加多个新增的Request
        for (Item item : items) {
            // 2.1.转换为文档类型ItemDTO
            ItemDoc itemDoc = BeanUtil.copyProperties(item, ItemDoc.class);
            // 2.2.创建新增文档的Request对象
            request.add(new IndexRequest()
                            .id(itemDoc.getId())
                            .source(JSONUtil.toJsonStr(itemDoc), XContentType.JSON));
        }
        // 3.发送请求
        client.bulk(request, RequestOptions.DEFAULT);

        // 翻页
        pageNo++;
    }
}
小结
文档操作的基本步骤:
- 初始化
RestHighLevelClient - 创建XxxRequest。
- XXX是
Index、Get、Update、Delete、Bulk - 准备参数(
Index、Update、Bulk时需要) - 发送请求。
- 调用
RestHighLevelClient#.xxx()方法,xxx是index、get、update、delete、bulk - 解析结果(
Get时需要)
ES高级查询
DSL查询
Elasticsearch的查询可以分为两大类:
- 叶子查询(Leaf query clauses):一般是在特定的字段里查询特定值,属于简单查询,很少单独使用。
- 复合查询(Compound query clauses):以逻辑方式组合多个叶子查询或者更改叶子查询的行为方式。
快速入门
查询的语法结构:
GET /{索引库名}/_search
{
  "query": {
    "查询类型": {
      // .. 查询条件
    }
  }
}
说明:
GET /{索引库名}/_search:其中的_search是固定路径,不能修改
例如,以最简单的无条件查询为例,无条件查询的类型是:match_all,因此其查询语句如下:
GET /items/_search
{
  "query": {
    "match_all": {

    }
  }
}
由于match_all无条件,所以条件位置不写即可
执行结果如下:
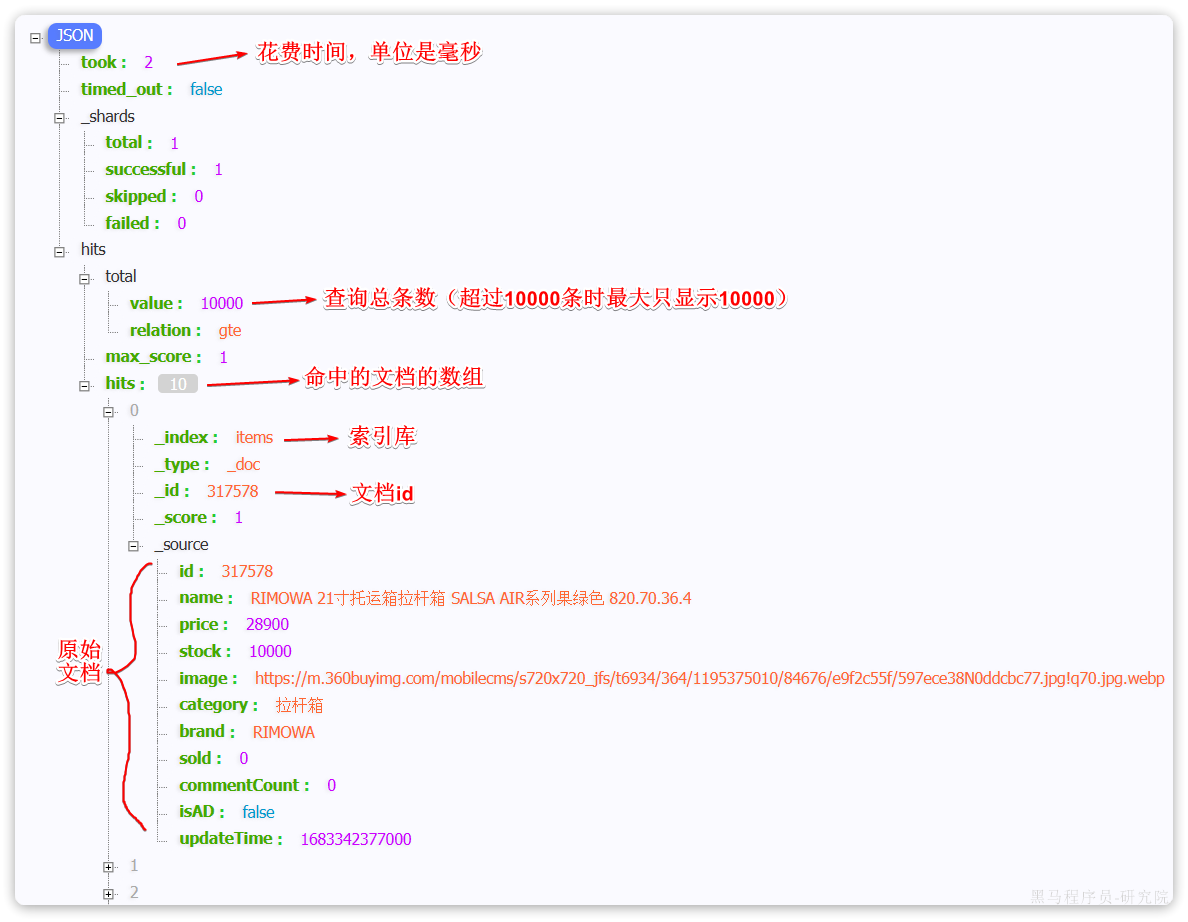
虽然是match_all,但是响应结果中并不会包含索引库中的所有文档,而是仅有10条。这是因为处于安全考虑,elasticsearch设置了默认的查询页数
叶子查询
叶子查询还可以进一步细分,常见的有:
- 全文检索(full text)查询:利用分词器对用户输入内容分词,然后去词条列表中匹配。例如:
- match_query
- multi_match_query
- 精确查询:不对用户输入内容分词,直接精确匹配,一般是查找keyword、数值、日期、布尔等类型。例如:
- ids
- range
- term
- 地理(geo)查询:用于搜索地理位置,搜索方式很多。例如:
- geo_distance
- geo_bounding_box
全文检索查询
match查询:全文检索的一种,会对用户输入内容分词,然后去倒排索引库检索,语法:
GET /indexName/_search
{
"query": {
"match": {
"FIELD": "TEXT"
}
}
}
multi_match:与match查询类似,只不过允许同时查询多个字段,语法:
GET /indexName/_search
{
"query": {
"multi_match": {
"query": "TEXT",
"fields": ["FIELD1", "FIELD2"]
}
}
}
精确查询
精确查询,英文是Term-level query,顾名思义,词条级别的查询。也就是说不会对用户输入的搜索条件再分词,而是作为一个词条,与搜索的字段内容精确值匹配
因此推荐查询keyword、数值、日期、boolean类型的字段。例如id、price、城市、地名、人名等作为一个整体才有含义
语法:
// term查询,可以看条件查询中的=符号
GET /indexName/_search
{
"query": {
"term": {
"FIELD": {
"value": "VALUE"
}
}
}
}
// range查询,字面意思范围查询
GET /indexName/_search
{
"query": {
"range": {
"FIELD": {
"gte": 10,
"lte": 20
}
}
}
}
gte:greater than and equals,也就是≥
lte:less than and equals,也就是≤
// id查询,查询匹配id值的文档
GET /items/_search
{
  "query": {
    "ids": {
      "values": ["VALUE1","VALUE2"]
    }
  }
}
复合查询
复合查询大致可以分为两类:
- 第一类:基于逻辑运算组合叶子查询,实现组合条件,例如
- bool
- 第二类:基于某种算法修改查询时的文档相关性算分,从而改变文档排名。例如:
- function_score
- dis_max
bool查询
布尔查询是一个或多个查询子句的组合。子查询的组合方式有:
- must:必须匹配每个子查询,类似”与”
- should:选择性匹配子查询,类似”或”
- must_not:必须不匹配,不参与算分,类似”非”
- filter:必须匹配,不参与算分
语法:
GET /items/_search
{
"query": {
"bool": {
"must": [
{"match": {"name": "手机"}}
],
"should": [
{"term": {"brand": {"value": "vivo"}}},
{"term": {"brand": {"value": "小米"}}}
],
"must_not": [
{"range": {"price": {"gte": 2500}}}
],
"filter": [
{"range": {"price": {"lte": 1000}}}
]
}
}
}
示例:
// 需要搜索"智能手机",但品牌必须为华为,且价格在900~1599之间
GET /items/_search
{
"query": {
"bool": {
"must": [
{"match": {"name": "智能手机"}}
],
"filter": [
{"term": {"brand": {"value": "华为"}}},
{"range": {"price": {"gte": 900,"lte": 1599}}}
]
}
}
}
算分函数查询
当利用match查询时,文档结果会根据与搜索词条的关联度打分(**_score**),返回结果时按照分值降序排列。
例如,搜索 “手机”,结果如下:
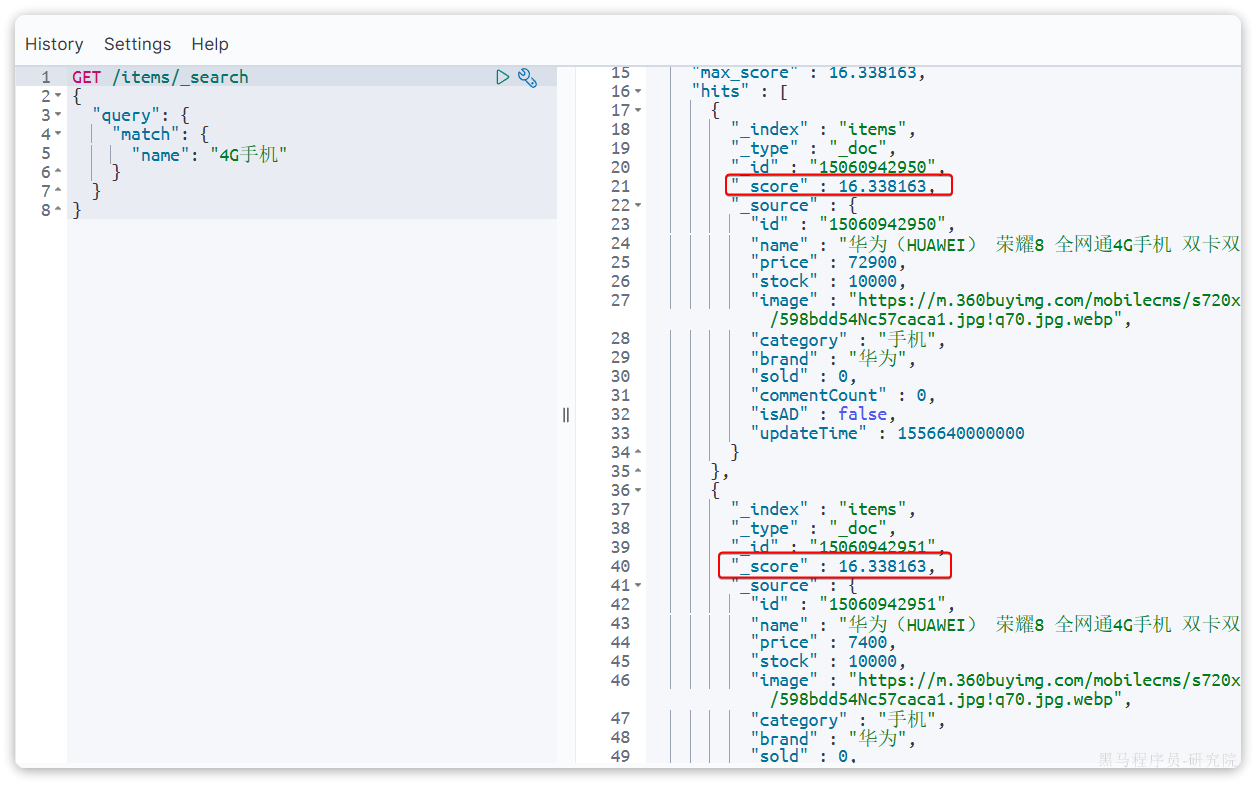
从elasticsearch5.1开始,采用的相关性打分算法是BM25算法,公式如下:
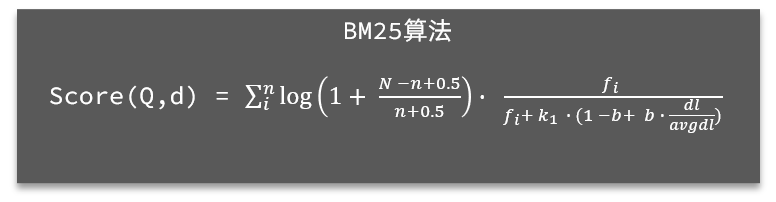
基于这套公式,就可以判断出某个文档与用户搜索的关键字之间的关联度,还是比较准确的。但是,在实际业务需求中,常常会有竞价排名的功能。不是相关度越高排名越靠前,而是掏的钱多的排名靠前
例如在百度中搜索Java培训,排名靠前的就是广告推广:
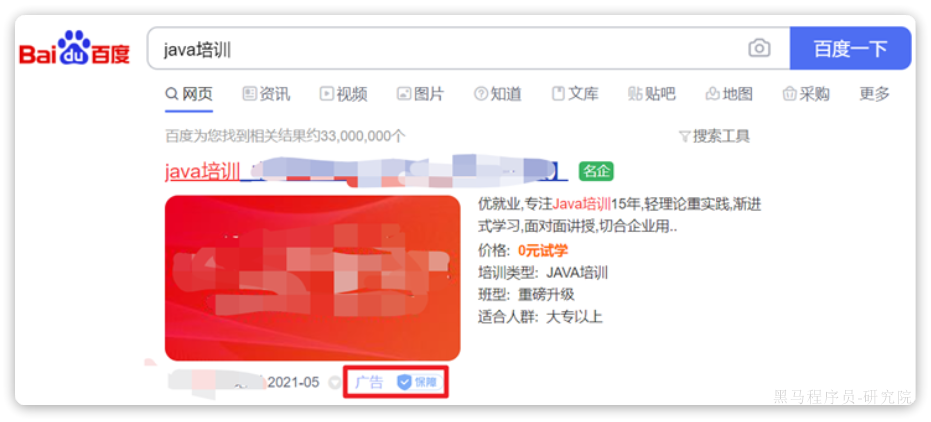
要想认为控制相关性算分,就需要利用elasticsearch中的function score 查询了
基本语法:
function score 查询中包含四部分内容:
- 原始查询条件:query部分,基于这个条件搜索文档,并且基于BM25算法给文档打分,原始算分(query score)
- 过滤条件:filter部分,符合该条件的文档才会重新算分
- 算分函数:符合filter条件的文档要根据这个函数做运算,得到的函数算分(function score),有四种函数
- weight:函数结果是常量
- field_value_factor:以文档中的某个字段值作为函数结果
- random_score:以随机数作为函数结果
- script_score:自定义算分函数算法
- 运算模式:算分函数的结果、原始查询的相关性算分,两者之间的运算方式,包括:
- multiply:相乘
- replace:用function score替换query score
- 其它,例如:sum、avg、max、min
function score的运行流程如下:
- 1)根据原始条件查询搜索文档,并且计算相关性算分,称为原始算分(query score)
- 2)根据过滤条件,过滤文档
- 3)符合过滤条件的文档,基于算分函数运算,得到函数算分(function score)
- 4)将原始算分(query score)和函数算分(function score)基于运算模式做运算,得到最终结果,作为相关性算分
因此,其中的关键点是:
- 过滤条件:决定哪些文档的算分被修改
- 算分函数:决定函数算分的算法
- 运算模式:决定最终算分结果
示例:给IPhone这个品牌的手机算分提高十倍,分析如下:
- 过滤条件:品牌必须为IPhone
- 算分函数:常量weight,值为10
- 算分模式:相乘multiply
对应代码如下:
GET /hotel/_search
{
  "query": {
    "function_score": {
      "query": {  .... }, // 原始查询,可以是任意条件
      "functions": [ // 算分函数
        {
          "filter": { // 满足的条件,品牌必须是Iphone
            "term": {
              "brand": "Iphone"
            }
          },
          "weight": 10 // 算分权重为2
        }
      ],
      "boost_mode": "multipy" // 加权模式,求乘积
    }
  }
}
排序
elasticsearch支持对搜索结果排序,默认是根据相关度算分(_score)来排序,也可以指定字段排序。可以排序字段类型有:keyword类型、数值类型、地理坐标类型、日期类型等
语法:
GET /indexName/_search
{
"query": {
"match_all": {}
},
"sort": [
"FIELD": "desc"// 排序字段和排序方式ASC、DESC
]
}
示例:
GET /items/_search
{
"query": {
"match_all": {}
},
"sort": [
{"sold": "desc"},
{"price": "asc"}
]
}
分页
基础分页
elasticsearch默认情况下只返回top10的数据。而如果要查询更多数据就需要修改分页参数了。elasticsearch中通过修改from、size参数来控制返回的分页结果
- from:从第几个文档开始
- size:总共查询几个文档
GET /items/_search
{
"query": {
"match_all": {}
},
"from": 0,
"size": 10,
"sort": [
{"price": "asc"}
]
}
示例:
// 搜索商品,查询出销量排名前10的产品,销量一样时按照价格升序
GET /items/_search
{
  "query": {
    "match_all": {}
  },
  "from": 0,
  "size": 3,
  "sort": [
    {
      "sold": "desc"
    },
    {
      "price": "asc"
    }
  ]
}
深度分页
elasticsearch的数据一般会采用分片存储,也就是把一个索引中的数据分成N份,存储到不同节点上。查询数据时需要汇总各个分片的数据
比如一个索引库中有100000条数据,分别存储到4个分片,每个分片25000条数据。现在每页查询10条,查询第99页。那么分页查询的条件如下:
GET /items/_search
{
  "from": 990, // 从第990条开始查询
  "size": 10, // 每页查询10条
  "sort": [
    {
      "price": "asc"
    }
  ]
}
从语句来分析,要查询第990~1000名的数据
从实现思路来分析,肯定是将所有数据排序,找出前1000名,截取其中的990~1000的部分。但问题来了,如何才能找到所有数据中的前1000名呢?
要知道每一片的数据都不一样,第1片上的第900~~1000,在另1个节点上并不一定依然是900~~1000名。所以只能**在每一个分片上都找出排名前1000的数据**,然后汇总到一起,重新排序,才能找出整个索引库中真正的前1000名,此时截取990~1000的数据即可
如图:
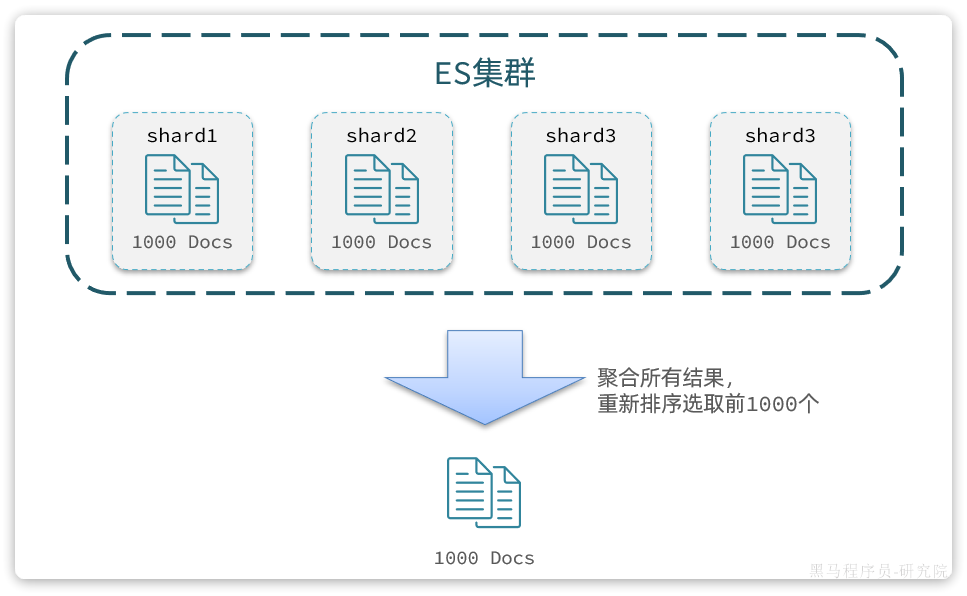
通俗理解:假设有10个班级,要想知道年级前十是谁,就只需要知道每个班级的前10即可
试想一下,假如现在要查询的是第999页数据呢,是不是要找第9990~10000的数据,那岂不是需要把每个分片中的前10000名数据都查询出来,汇总在一起,在内存中排序?如果查询的分页深度更深呢,需要一次检索的数据岂不是更多?
由此可知,当查询分页深度较大时,汇总数据过多,对内存和CPU会产生非常大的压力
因此elasticsearch会禁止from+ size 超过10000的请求
针对深度分页,elasticsearch提供了两种解决方案:
search after:分页时需要排序,原理是从上一次的排序值开始,查询下一页数据。官方推荐使用的方式scroll:原理将排序后的文档id形成快照,保存下来,基于快照做分页。官方已经不推荐使用
详情见文档:https://www.elastic.co/guide/en/elasticsearch/reference/7.12/paginate-search-results.html
总结:
大多数情况下,采用普通分页就可以了。查看百度、京东等网站,会发现其分页都有限制。例如百度最多支持77页,每页不足20条。京东最多100页,每页最多60条
因此,一般采用限制分页深度的方式即可,无需实现深度分页
高亮显示
高亮显示:就是在搜索结果中把搜索关键字突出显示
语法:
GET /items/_search
{
"query": {
"match": {
"FIELD": "TEXT"
}
},
"highlight": {
"fields": {
"FIELD": {
"pre_tags": "<em>",
"post_tags": "</em>"
}
}
}
}
示例:
GET /items/_search
{
  "query": {
    "match": {
      "name": "牛奶"
    }
  },
  "highlight": {
    "fields": {
      "name": {
        "pre_tags": "<em>",
        "post_tags": "</em>"
      }
    }
  }
}
注意:如果不指定”pre_tags”和”post_tags”的具体值,那默认情况下就是””和””
RestClient查询
快速入门
数据搜索的Java代码分为两部分:
构建并发起请求
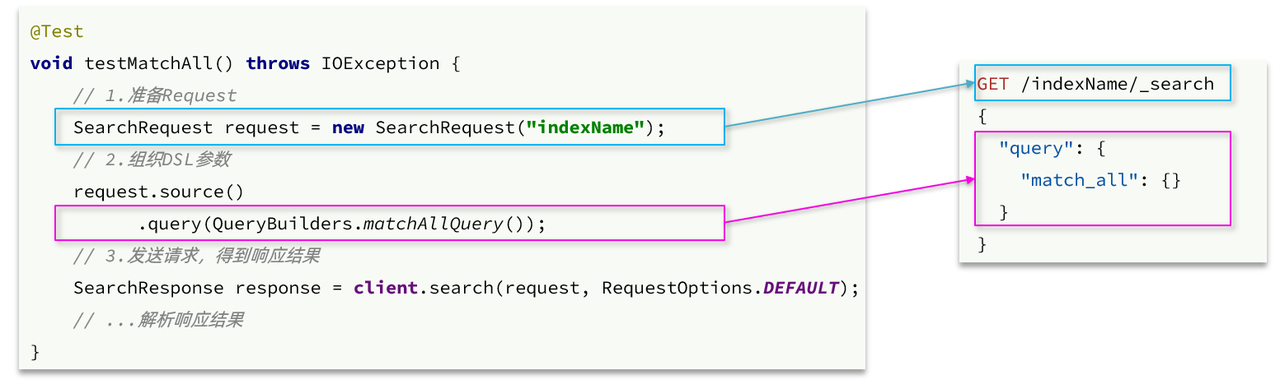
代码解读:
- 第一步,创建
SearchRequest对象,指定索引库名 - 第二步,利用
request.source()构建DSL,DSL中可以包含查询、分页、排序、高亮等 query():代表查询条件,利用QueryBuilders.matchAllQuery()构建一个match_all查询的DSL- 第三步,利用
client.search()发送请求,得到响应
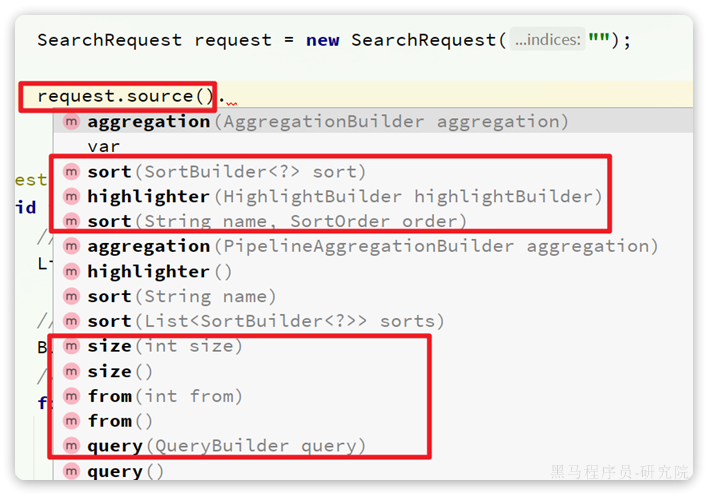
这里关键的API有两个,一个是request.source(),它构建的就是DSL中的完整JSON参数。其中包含了query、sort、from、size、highlight等所有功能:
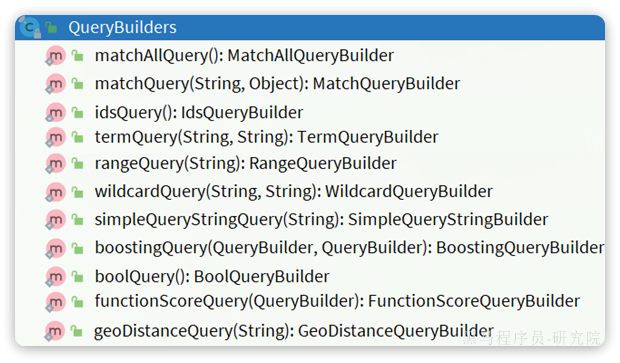
另一个是QueryBuilders,其中包含了我们学习过的各种叶子查询、复合查询等:
解析查询结果
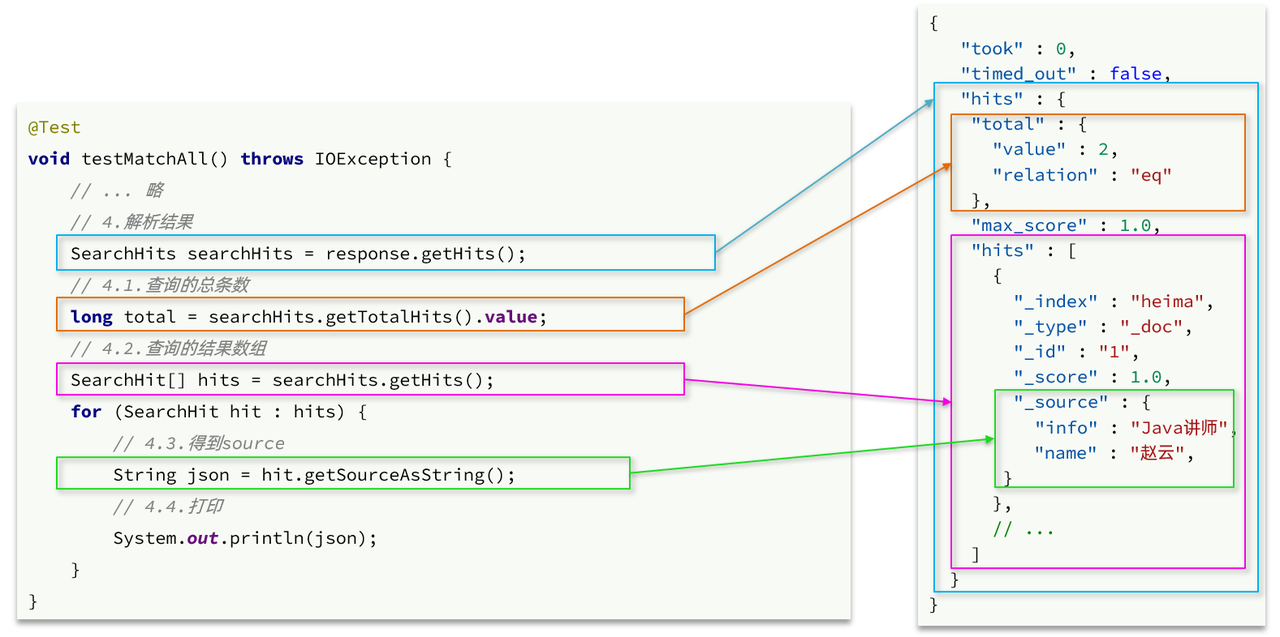
在发送请求以后,得到了响应结果SearchResponse,这个类的结构与kibana中看到的响应结果JSON结构完全一致:
{
    "took" : 0,
    "timed_out" : false,
    "hits" : {
        "total" : {
            "value" : 2,
            "relation" : "eq"
        },
        "max_score" : 1.0,
        "hits" : [
            {
                "_index" : "heima",
                "_type" : "_doc",
                "_id" : "1",
                "_score" : 1.0,
                "_source" : {
                "info" : "Java讲师",
                "name" : "赵云"
                }
            }
        ]
    }
}
因此,解析SearchResponse的代码就是在解析这个JSON结果,对比如下:
总结
文档搜索的基本步骤是:
- 创建
SearchRequest对象 - 准备
request.source(),也就是DSL -QueryBuilders来构建查询条件 - 传入request.source()的query()方法 - 发送请求,得到结果
- 解析结果(参考JSON结果,从外到内,逐层解析)
完整代码如下:
@Test
void testMatchAll() throws IOException {
    // 1.创建Request
    SearchRequest request = new SearchRequest("items");
    // 2.组织请求参数
    request.source().query(QueryBuilders.matchAllQuery());
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);
}

private void handleResponse(SearchResponse response) {
    SearchHits searchHits = response.getHits();
    // 1.获取总条数
    long total = searchHits.getTotalHits().value;
    System.out.println("共搜索到" + total + "条数据");
    // 2.遍历结果数组
    SearchHit[] hits = searchHits.getHits();
    for (SearchHit hit : hits) {
        // 3.得到_source,也就是原始json文档
        String source = hit.getSourceAsString();
        // 4.反序列化并打印
        ItemDoc item = JSONUtil.toBean(source, ItemDoc.class);
        System.out.println(item);
    }
}
叶子查询
所有的查询条件都是由QueryBuilders来构建的,叶子查询也不例外。因此整套代码中变化的部分仅仅是query条件构造的方式,其它不动
全文检索查询
match查询:
@Test
void testMatch() throws IOException {
    // 1.创建Request
    SearchRequest request = new SearchRequest("items");
    // 2.组织请求参数
    request.source().query(QueryBuilders.matchQuery("name", "脱脂牛奶"));
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);
}
multi_match查询:
@Test
void testMultiMatch() throws IOException {
    // 1.创建Request
    SearchRequest request = new SearchRequest("items");
    // 2.组织请求参数
    request.source().query(QueryBuilders.multiMatchQuery("脱脂牛奶", "name", "category"));
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);
}
精确查询
range查询:
@Test
void testRange() throws IOException {
    // 1.创建Request
    SearchRequest request = new SearchRequest("items");
    // 2.组织请求参数
    request.source().query(QueryBuilders.rangeQuery("price").gte(10000).lte(30000));
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);
}
term查询:
@Test
void testTerm() throws IOException {
    // 1.创建Request
    SearchRequest request = new SearchRequest("items");
    // 2.组织请求参数
    request.source().query(QueryBuilders.termQuery("brand", "华为"));
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);
}
id查询:
@Test
void testIds() throws IOException {
    // 1. 创建request对象
    SearchRequest request = new SearchRequest("items");
    // 2. 配置request对象
    request.source().query(QueryBuilders.idsQuery().addIds("3541053", "5188792"));
    // 3. 获取结果
    SearchResponse search = client.search(request, RequestOptions.DEFAULT);
    // 4. 解析结果
    handleResponse(search);
}
复合查询
bool查询
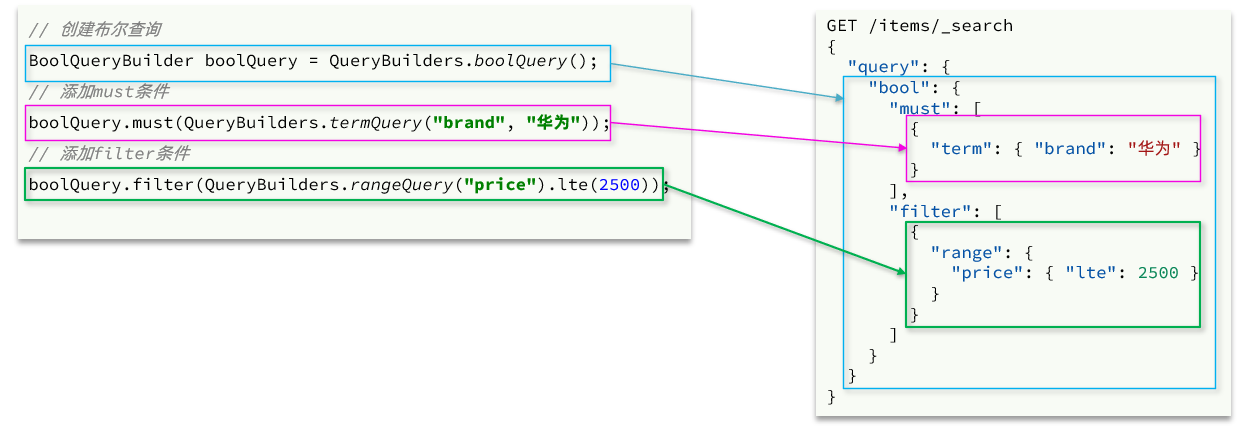
复合查询也是由QueryBuilders来构建,DSL和JavaAPI的对比如图:
完整代码如下:
@Test
void testBool() throws IOException {
    // 1.创建Request
    SearchRequest request = new SearchRequest("items");
    // 2.组织请求参数
    // 2.1.准备bool查询
    BoolQueryBuilder bool = QueryBuilders.boolQuery();
    // 2.2.关键字搜索
    bool.must(QueryBuilders.matchQuery("name", "脱脂牛奶"));
    // 2.3.品牌过滤
    bool.filter(QueryBuilders.termQuery("brand", "德亚"));
    // 2.4.价格过滤
    bool.filter(QueryBuilders.rangeQuery("price").lte(30000));
    request.source().query(bool);
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);
}
排序和分页
之前说过,requeset.source()就是整个请求JSON参数,所以排序、分页都是基于这个来设置,其DSL和JavaAPI的对比如下:
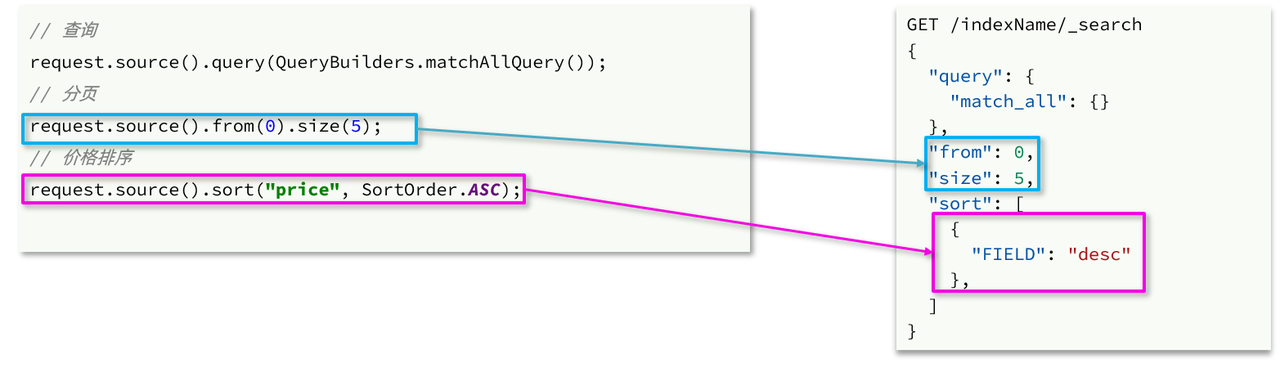
完整示例代码:
@Test
void testPageAndSort() throws IOException {
    int pageNo = 1, pageSize = 5;

    // 1.创建Request
    SearchRequest request = new SearchRequest("items");
    // 2.组织请求参数
    // 2.1.搜索条件参数
    request.source().query(QueryBuilders.matchQuery("name", "脱脂牛奶"));
    // 2.2.排序参数
    request.source().sort("price", SortOrder.ASC);
    // 2.3.分页参数
    request.source().from((pageNo - 1) * pageSize).size(pageSize);
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);
}
高亮
高亮查询与前面的查询有两点不同:
- 条件同样是在
request.source()中指定,只不过高亮条件要基于HighlightBuilder来构造 - 高亮响应结果与搜索的文档结果不在一起,需要单独解析
首先来看高亮条件构造,其DSL和JavaAPI的对比如图:
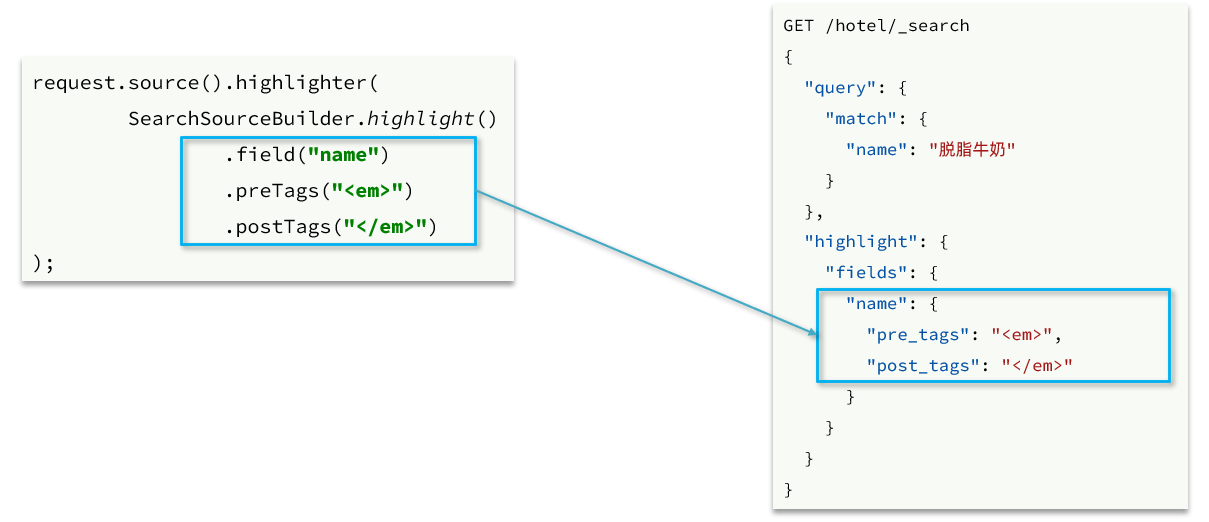
示例代码如下:
@Test
void testHighlight() throws IOException {
    // 1.创建Request
    SearchRequest request = new SearchRequest("items");
    // 2.组织请求参数
    // 2.1.query条件
    request.source().query(QueryBuilders.matchQuery("name", "脱脂牛奶"));
    // 2.2.高亮条件
    request.source().highlighter(
            SearchSourceBuilder.highlight()
                    .field("name")
                    .preTags("<em>")
                    .postTags("</em>")
    );
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);
}
再来看结果解析,文档解析的部分不变,主要是高亮内容需要单独解析出来,其DSL和JavaAPI的对比如图:
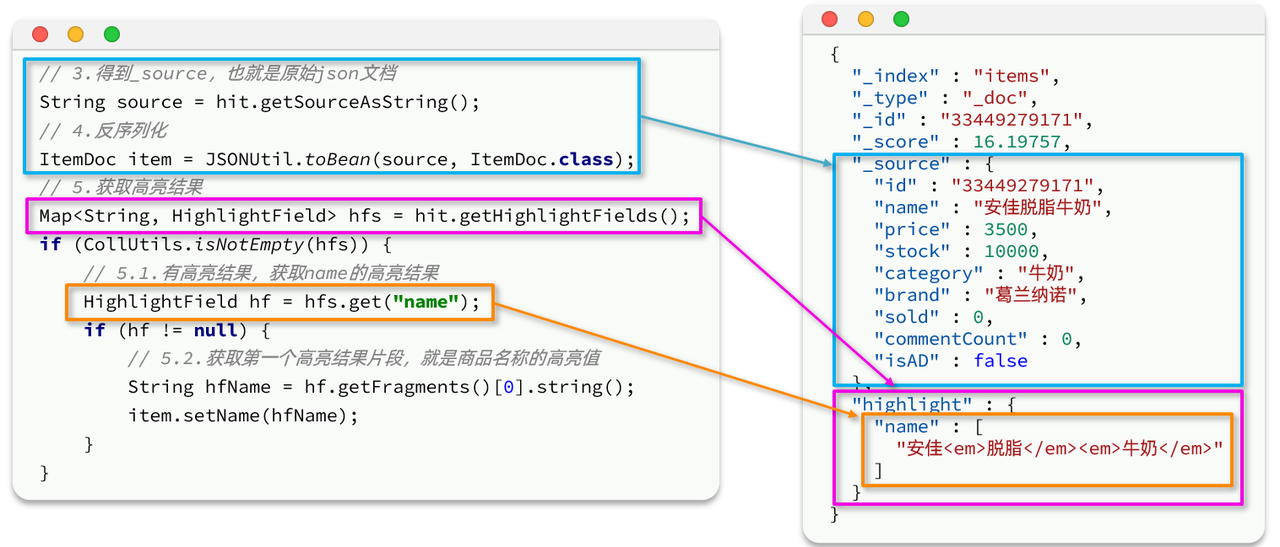
代码解读:
- 第
3、4步:从结果中获取_source。hit.getSourceAsString(),这部分是非高亮结果,json字符串。还需要反序列为ItemDoc对象 - 第
5步:获取高亮结果。hit.getHighlightFields(),返回值是一个Map,key是高亮字段名称,值是HighlightField对象,代表高亮值 - 第
5.1步:从Map中根据高亮字段名称,获取高亮字段值对象HighlightField - 第
5.2步:从HighlightField中获取Fragments,并且转为字符串。这部分就是真正的高亮字符串了 - 最后:用高亮的结果替换
ItemDoc中的非高亮结果
完整代码如下:
private void handleResponse(SearchResponse response) {
    SearchHits searchHits = response.getHits();
    // 1.获取总条数
    long total = searchHits.getTotalHits().value;
    System.out.println("共搜索到" + total + "条数据");
    // 2.遍历结果数组
    SearchHit[] hits = searchHits.getHits();
    for (SearchHit hit : hits) {
        // 3.得到_source,也就是原始json文档
        String source = hit.getSourceAsString();
        // 4.反序列化
        ItemDoc item = JSONUtil.toBean(source, ItemDoc.class);
        // 5.获取高亮结果
        Map<String, HighlightField> hfs = hit.getHighlightFields();
        if (CollUtils.isNotEmpty(hfs)) {
            // 5.1.有高亮结果,获取name的高亮结果
            HighlightField hf = hfs.get("name");
            if (hf != null) {
                // 5.2.获取第一个高亮结果片段,就是商品名称的高亮值
                String hfName = hf.getFragments()[0].string();
                item.setName(hfName);
            }
        }
        System.out.println(item);
    }
}
数据聚合
聚合(aggregations)可以极其方便的实现对数据的统计、分析、运算。例如:
- 什么品牌的手机最受欢迎?
- 这些手机的平均价格、最高价格、最低价格?
- 这些手机每月的销售情况如何?
实现这些统计功能的比数据库的sql要方便的多,而且查询速度非常快,可以实现近实时搜索效果。
官方文档:Elastic
聚合常见的有三类:
- 桶(
Bucket)聚合:用来对文档做分组 TermAggregation:按照文档字段值分组,例如按照品牌值分组、按照国家分组Date Histogram:按照日期阶梯分组,例如一周为一组,或者一月为一组- 度量(
Metric)聚合:用以计算一些值,比如:最大值、最小值、平均值等 Avg:求平均值Max:求最大值Min:求最小值Stats:同时求max、min、avg、sum等- 管道(
pipeline)聚合:其它聚合的结果为基础做进一步运算
注意:参与聚合的字段必须是Keyword、数值、日期、布尔的类型的字段
DSL聚合
Bucket聚合
基本语法如下:
GET /items/_search
{
  "size": 0,
  "aggs": {
    "category_agg": {
      "terms": {
        "field": "category",
        "size": 20
      }
    }
  }
}
语法说明:
size:设置size为0,就是每页查0条,则结果中就不包含文档,只包含聚合aggs:定义聚合category_agg:聚合名称,自定义,但不能重复terms:聚合的类型,按分类聚合,所以用termfield:参与聚合的字段名称size:希望返回的聚合结果的最大数量
查询的结果:
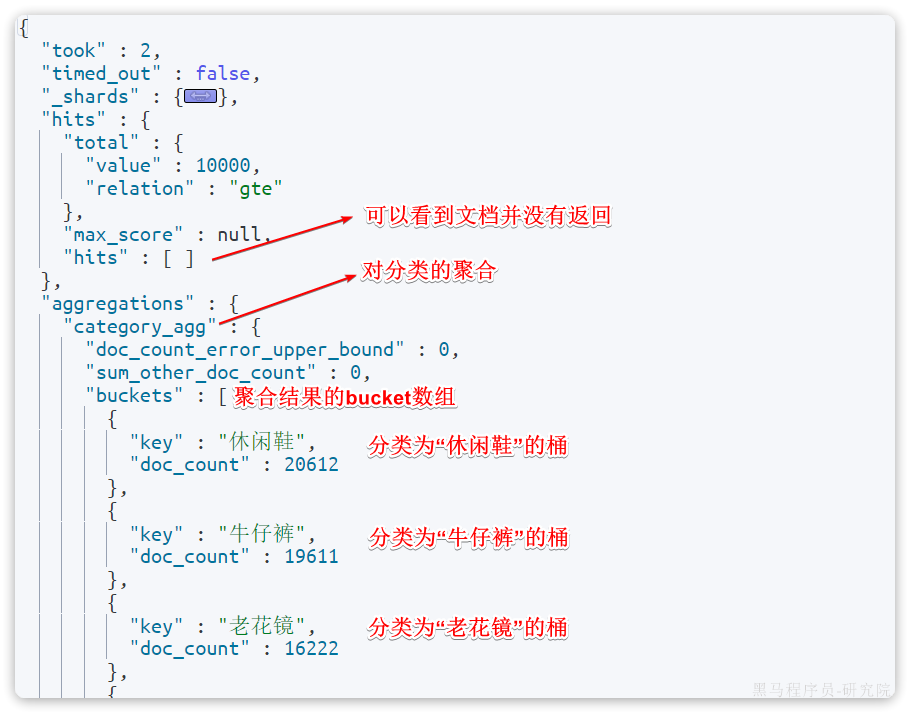
带条件聚合
默认情况下,Bucket聚合是对索引库的所有文档做聚合
如果想要限定聚合的文档范围,只要添加query条件即可
例如,用户想要知道高于3000元的手机品牌有哪些:
GET /items/_search
{
  "query": {
    "bool": {
      "filter": [
        {"term": {"category": "手机"}},
        {"range": {"price": {"gte": 300000}}}
      ]
    }
  },
  "aggs": {
    "brand_aggs": {
      "terms": {
        "field": "brand",
        "size": 10
      }
    }
  }
}
Metric聚合
如果需要对桶内的商品做运算,获取每个品牌价格的最小值、最大值、平均值
这就要用到Metric聚合了,例如stat聚合,就可以同时获取min、max、avg等结果
语法如下:
GET /items/_search
{
  "query": {
    "bool": {
      "filter": [
        {"term": {"category": "手机"}},
        {"range": {"price": {"gte": 300000}}}
      ]
    }
  },
  "aggs": {
    "brand_aggs": {
      "terms": {
        "field": "brand",
        "size": 10
      },
      "aggs": {
        "metric_aggs": {
          "stats": {
            "field": "price"
          }
        }
      }
    }
  }
}
可以看到在brand_agg聚合的内部,新加了一个aggs参数。这个聚合就是brand_agg的**子聚合**,会对brand_agg形成的每个桶中的文档分别统计。
stats_meric:聚合名称stats:聚合类型,stats是metric聚合的一种field:聚合字段,这里选择price,统计价格
另外,还可以让聚合按照每个品牌的价格平均值排序:
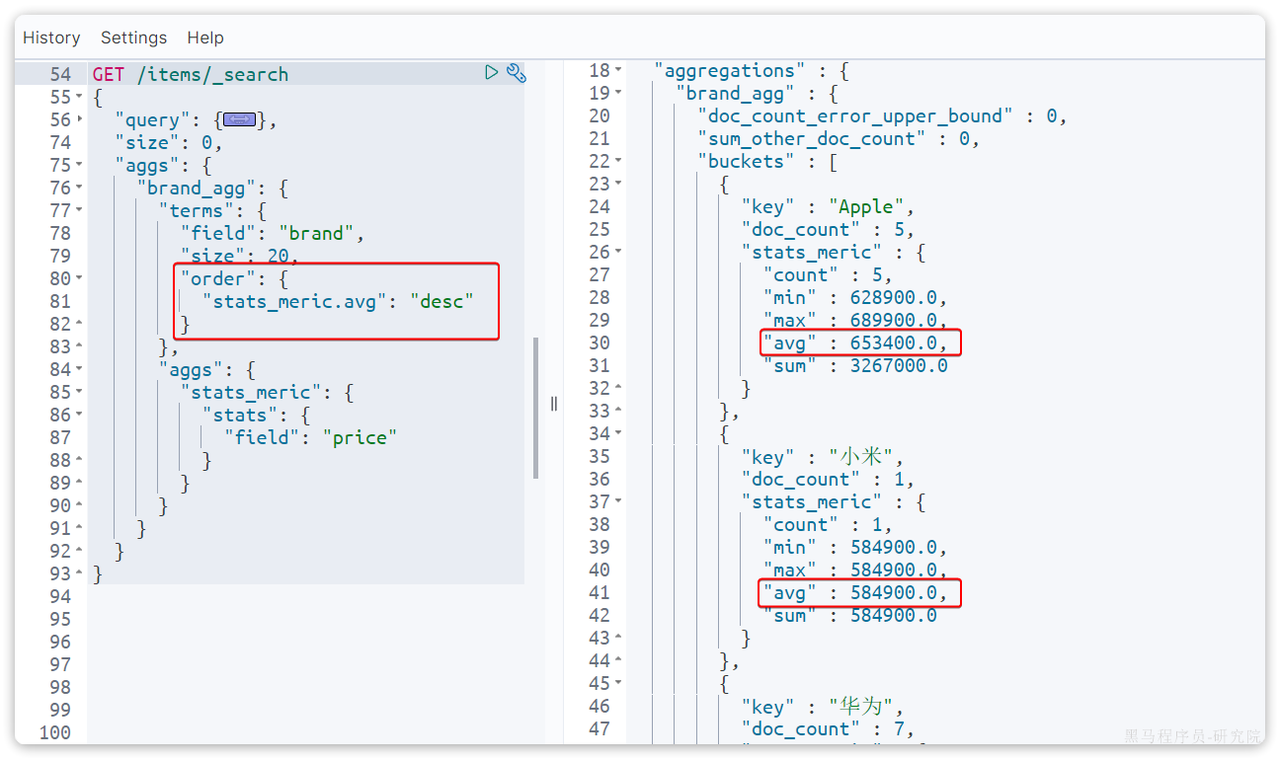
总结
aggs代表聚合,与query同级,此时query的作用是?
- 限定聚合的的文档范围
聚合必须的三要素:
- 聚合名称
- 聚合类型
- 聚合字段
聚合可配置属性有:
- size:指定聚合结果数量
- order:指定聚合结果排序方式
- field:指定聚合字段
RestClient聚合
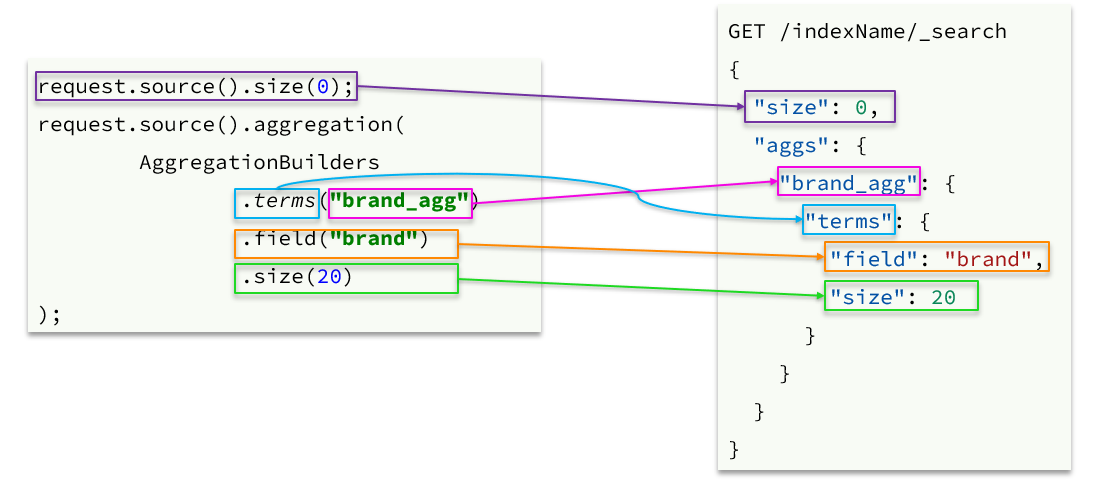
可以看到在DSL中,aggs聚合条件与query条件是同一级别,都属于查询JSON参数。因此依然是利用request.source()方法来设置。
不过聚合条件的要利用AggregationBuilders这个工具类来构造。DSL与JavaAPI的语法对比如下:
聚合结果与搜索文档同一级别,因此需要单独获取和解析。具体解析语法如下:
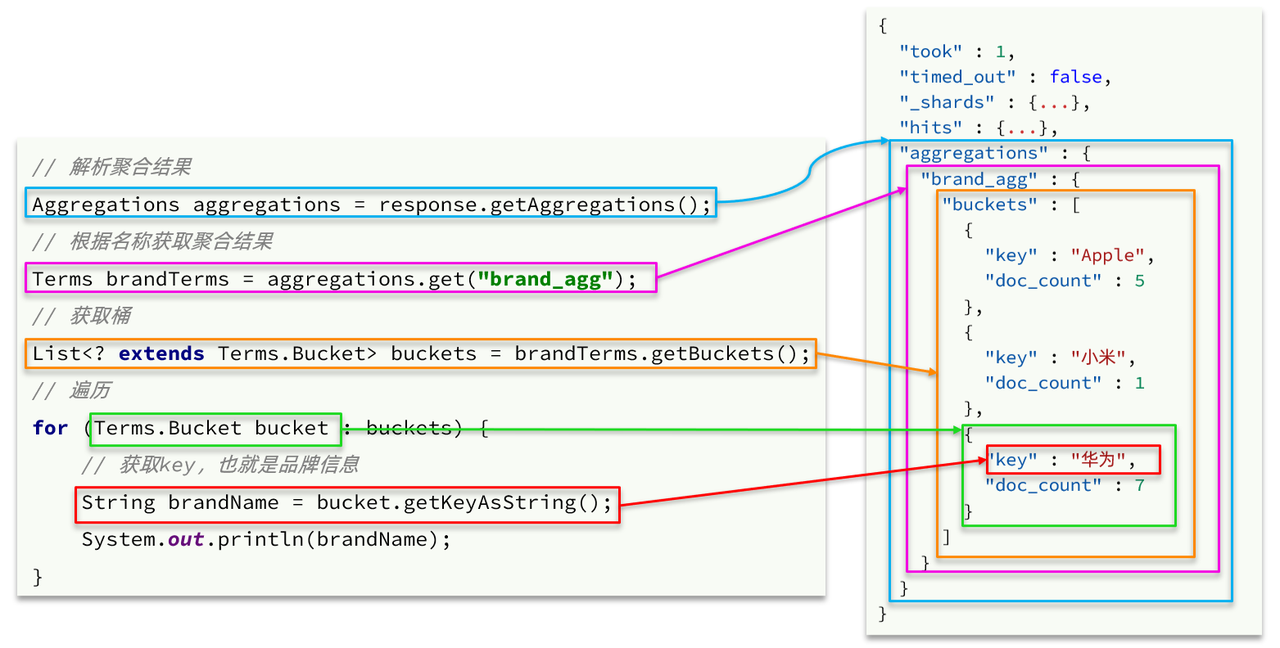
完整代码如下:
@Test
void testAgg() throws IOException {
    // 1.创建Request
    SearchRequest request = new SearchRequest("items");
    // 2.准备请求参数
    BoolQueryBuilder bool = QueryBuilders.boolQuery()
            .filter(QueryBuilders.termQuery("category", "手机"))
            .filter(QueryBuilders.rangeQuery("price").gte(300000));
    request.source().query(bool).size(0);
    // 3.聚合参数
    request.source().aggregation(
            AggregationBuilders.terms("brand_agg").field("brand").size(5)
    );
    // 4.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 5.解析聚合结果
    Aggregations aggregations = response.getAggregations();
    // 5.1.获取品牌聚合
    Terms brandTerms = aggregations.get("brand_agg");
    // 5.2.获取聚合中的桶
    List<? extends Terms.Bucket> buckets = brandTerms.getBuckets();
    // 5.3.遍历桶内数据
    for (Terms.Bucket bucket : buckets) {
        // 5.4.获取桶内key
        String brand = bucket.getKeyAsString();
        System.out.print("brand = " + brand);
        long count = bucket.getDocCount();
        System.out.println("; count = " + count);
    }
}
这里需要注意在解析聚合结果这部分,
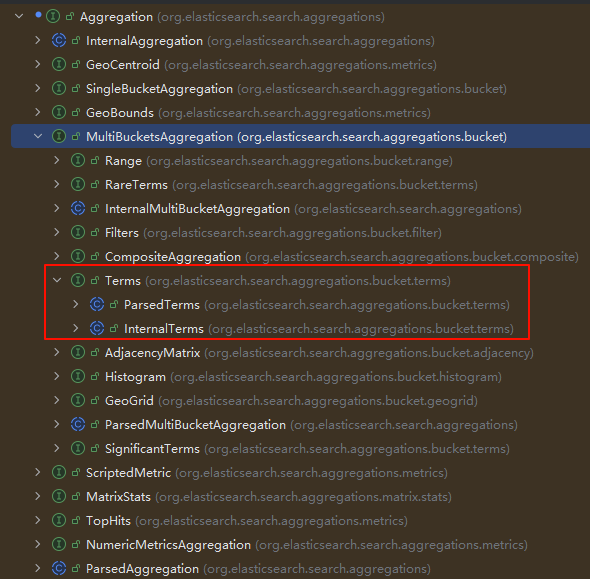
aggregations.get("brand_agg");它的返回值类型是Aggregation,但是这个类型是一个父接口,无法直接调用getBuckets这个方法。因为这个方法存在于它的子接口MultiBucketsAggregation下的Terms接口类型(多态)